こんにちは。最近 Infrastructure チームから Matching チームへ異動した笠井(@unblee)です。
Matching チームは Wantedly Visit におけるユーザと企業の理想のマッチングを実現するために推薦システムの改良や、データサイエンスを活用したプロダクト開発に責任を持ち、現在 ML 基盤を作るサブチーム 2人(+内定インターン1人)、Data Scientist 4人が所属しています。
この記事は、チーム内の Data Scientist に対して社内で利用しているインフラ周りの知識、具体的には 利用している SaaS(具体的には New Relic と Honeybadger)の使い方と Kubernetes、Workflow Engine の基礎知識について速習会をしたときの資料を一般公開用に修正したものです。
社内で行われている取り組みについてオープンにすることで、社外のエンジニアや学生の方に Wantedly のエンジニアについて興味を持っていただけたら嬉しいです。
Agenda
- 背景・モチベーション
- New Relic
- Honeybadger
- Datadog
- Kubernetes
- Argo Workflow
- まとめ
背景・モチベーション
Wantedly では Infrastructure チームと Developer Experience(DX) チームが主導して、エンジニア自身がアプリケーションをデプロイ、モニタリングし継続的に生産性を高めていける社内インフラのプラットフォーム化を推進しています。しかしながら、そういった社内で作られた便利な仕組みやその使い方、あるいはエンジニアの間で流行っている便利ツールや技術、プロジェクト進行のベストプラクティスといった知見については全員が全ての情報をキャッチアップ出来るとは限らないため、以前は各個人が持っている知見がスケールしないという課題が開発チーム内にありました。
この課題を解決するために、8月ごろから「開発チーム全体としての技術力・課題解決能力が高められる & その状態が維持できる状態」を最終的なゴールとして、「知見が広がる、蓄積される」という状態を最初に実現するために、Tech Lunch というトピックを限定しない LT 大会のようなものを毎週開催するようになりました。こういった知見を共有する場を明示的に設けることによって以前より各人の知見を共有するハードルが低くなり、また、これに加えてより1つのトピックの掘り下げ、スコープの限定を前提にある程度の時間を確保して行う速習会というスタイルで知見を共有する機会も散発的に行われているため、徐々に全体の能力の底上げが実現されていると感じています。
こういった最近の社内の動きとちょうど私が Infrastructure チームから異動してきたタイミングが合わさって、インフラ周りの知見が共有されにくくその周辺知見が欠落していることによって生産性を下げているのではないか、という課題が挙がっていた Data Scientist にスコープを絞り、社内のインフラ周りでどのようなツールが何のためにどうやって使われているのかという知見を共有するための速習会を行う機会が設けられました。
速習会の目的と期待値は以下の通りです。
- 目的
- Data Scientist が普段触ることが少ないアプリケーションやインフラレイヤのモニタリングツール、ミドルウェアについてざっくり知ることで、何かしら困ったときに何となくこの資料(のリンク)を思い出して、調査で使える選択肢を増やせる程度に知識をアップデートする
- 期待値
- SaaS については、何が何をするために使われているのか観測したいものがあるときどこで何をどうやって見れば良いのかがわかる
- 使いこなすみたいなところまでは期待しない
- 障害対応してる人たちが何を見てどう解釈しているのかを何となく知る
- Kubernetes については、よく聞く用語が何を意味しているのかを知る
ここからは実際に速習会で共有した資料を一般公開向けに修正したものを共有したいと思います。
New Relic

パフォーマンス分析プラットフォーム | New Relic(ニューレリック)
Wantedly において何をするために使われているか
主にアプリケーションレイヤのパフォーマンスを記録・観測するために使われています。このため New Relic には多くの機能がありますが、エンジニアが日常的に使っているのは APM(Application Performance Monitor)になります。他にもサービスの監視のために Synthetics を使ってパフォーマンスが事前に決められたしきい値を超過したことを検出してアラートを発火させるということもやっていますが、ここでは詳細は説明しません。
使い方
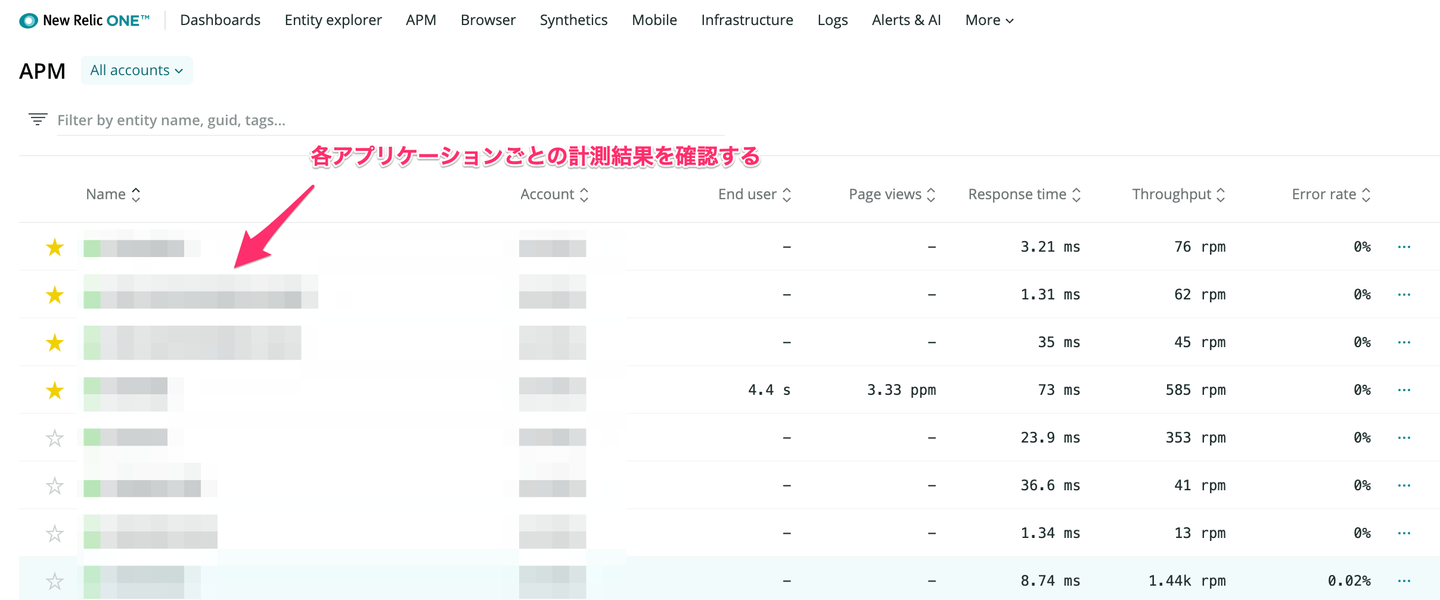
APM のトップページには New Relic での監視が有効になっているアプリケーション一覧が表示されているので、ここから観測したいアプリケーションを選択します。
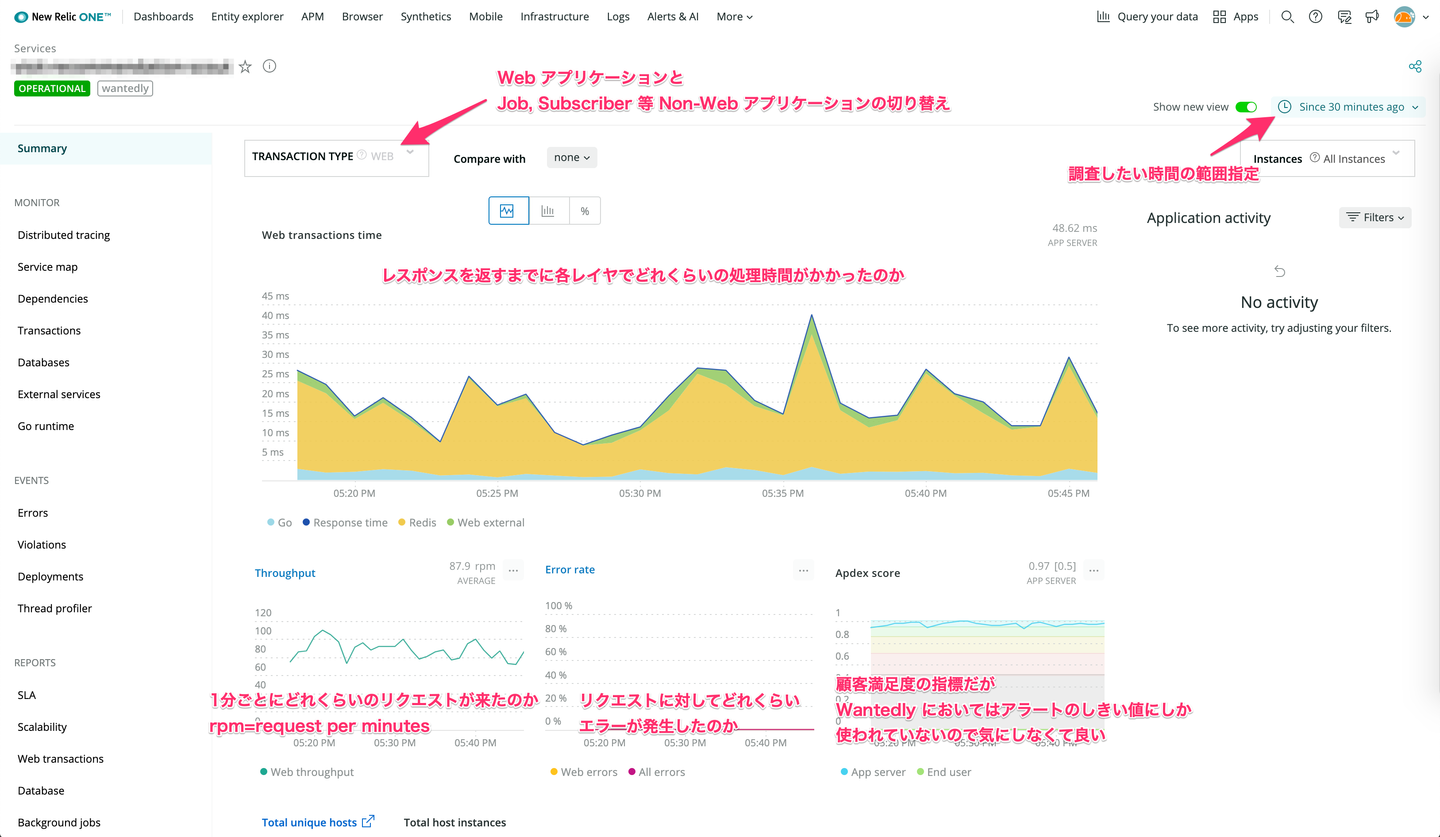
アプリケーションを選択すると以下のような Summary 画面に遷移します。基本的に調査はここを起点に行われます。例えば Web Transaction を見て全体のレスポンスタイムが遅くなっていないか、どのレイヤで遅くなっているのかを確認する。また、Error Rate が上がっているようであれば Error Rate を確認します。
ここで重要なのは観測対象の Time Range を広げて時系列における値の動きの傾向を把握することです。一見問題が起こっているように見えても、Time Range を広げると定期的に起きていること(e.g. いつも月曜日に起こってるとか、毎日09:00頃に起こってるとか)だったりして、問題ではあるが緊急性は低いみたいな状況はよくあるのでとりあえず Time Range を広げることは意識しておくと良いと思います。
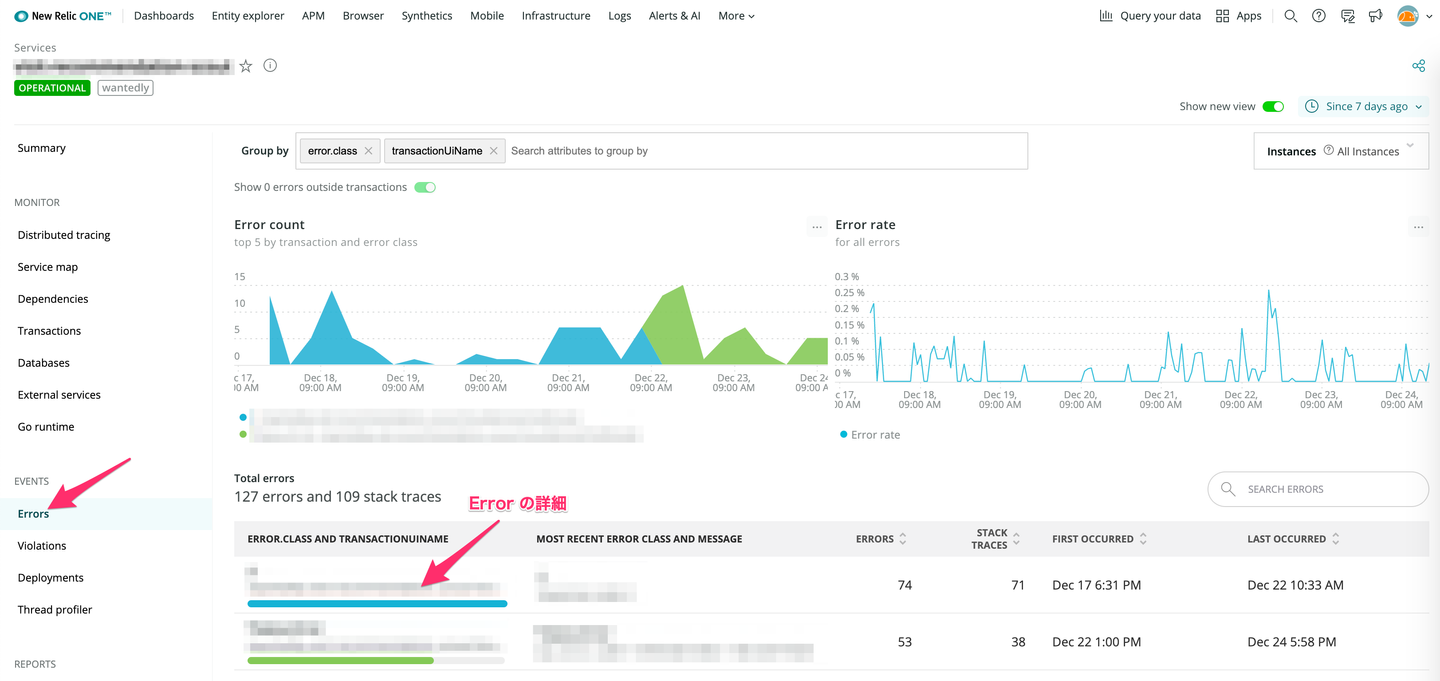
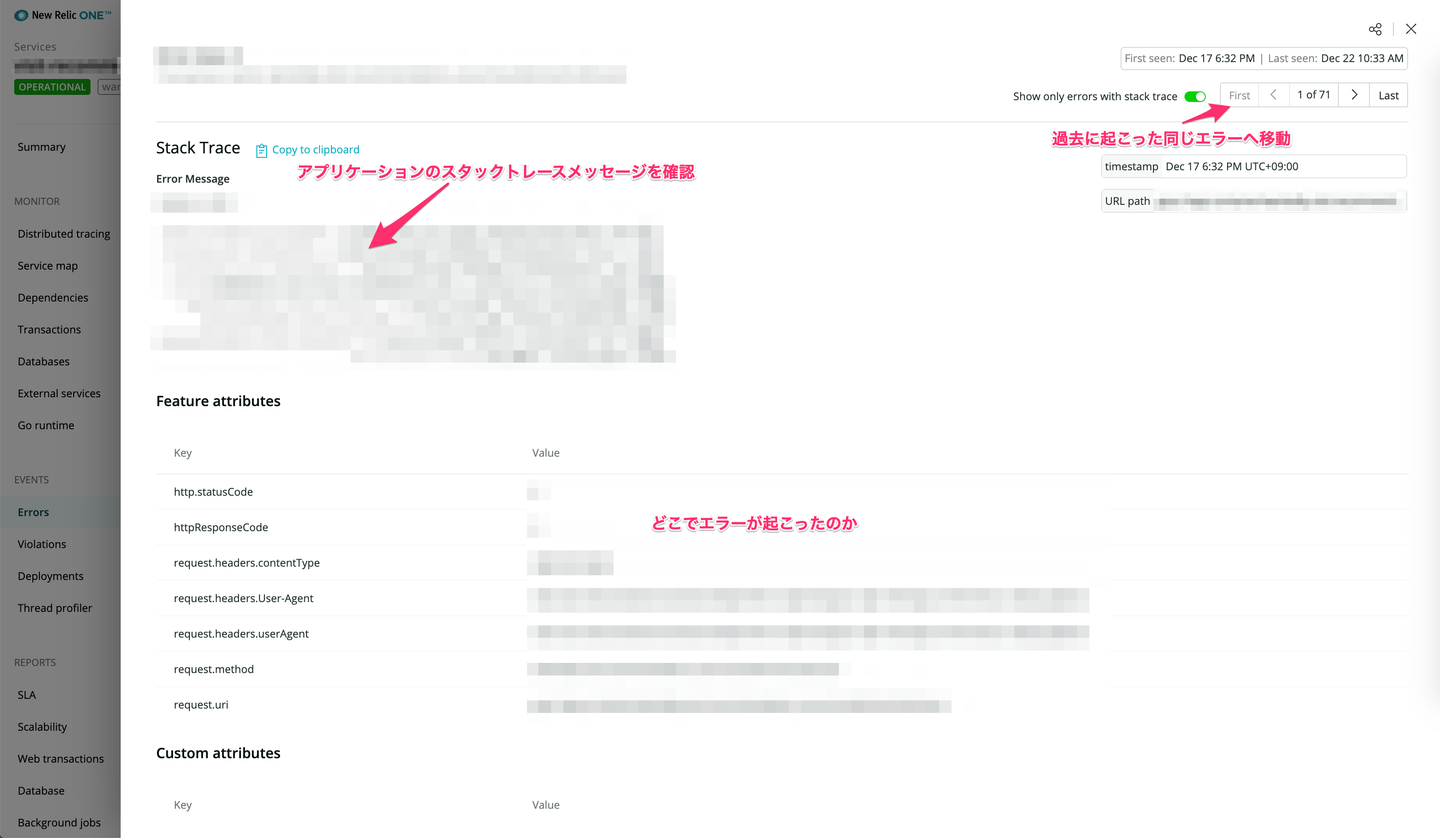
Summary ページ内の Error Rate もしくはサイドバーの Errors を選択すると以下のようなアプリケーションで発生した Error を確認するためのページに遷移します。何かしら障害が発生したときに確認するページですが、Wantedly においてエラーログのトラッキングには後述する Honeybadger を利用しているので社内で知見が溜まっている Honeybadger をメインで使って、こちらは補助的に使うのが良いかもしれません。
Honeybadger

Exception and Uptime Monitoring for Application Developers
Wantedly において何をするために使われているか
主にアプリケーションで発生したエラーを記録・観測するため、エラーによってアラートを発火させるために Honeybadger というエラートラッキングサービスを利用しています。
使い方
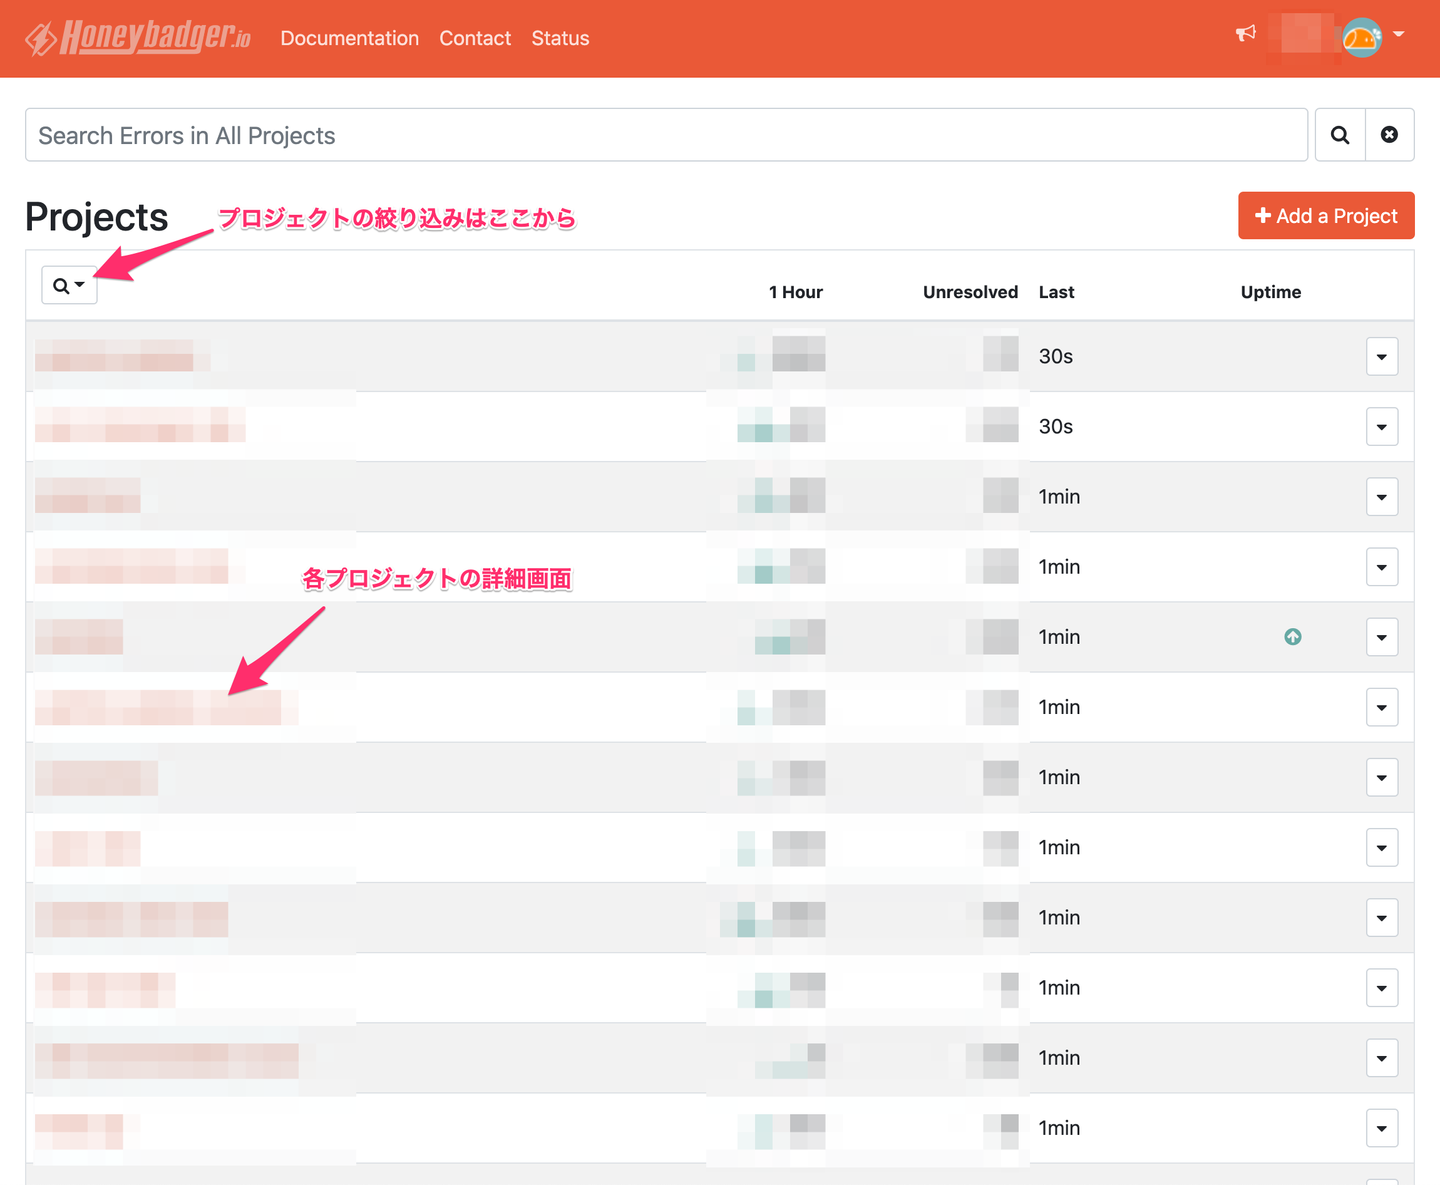
トップページに行くと Honeybadger でエラーをトラッキングしているプロジェクト(アプリケーション)が一覧になっているので観測したいものを選択してください。
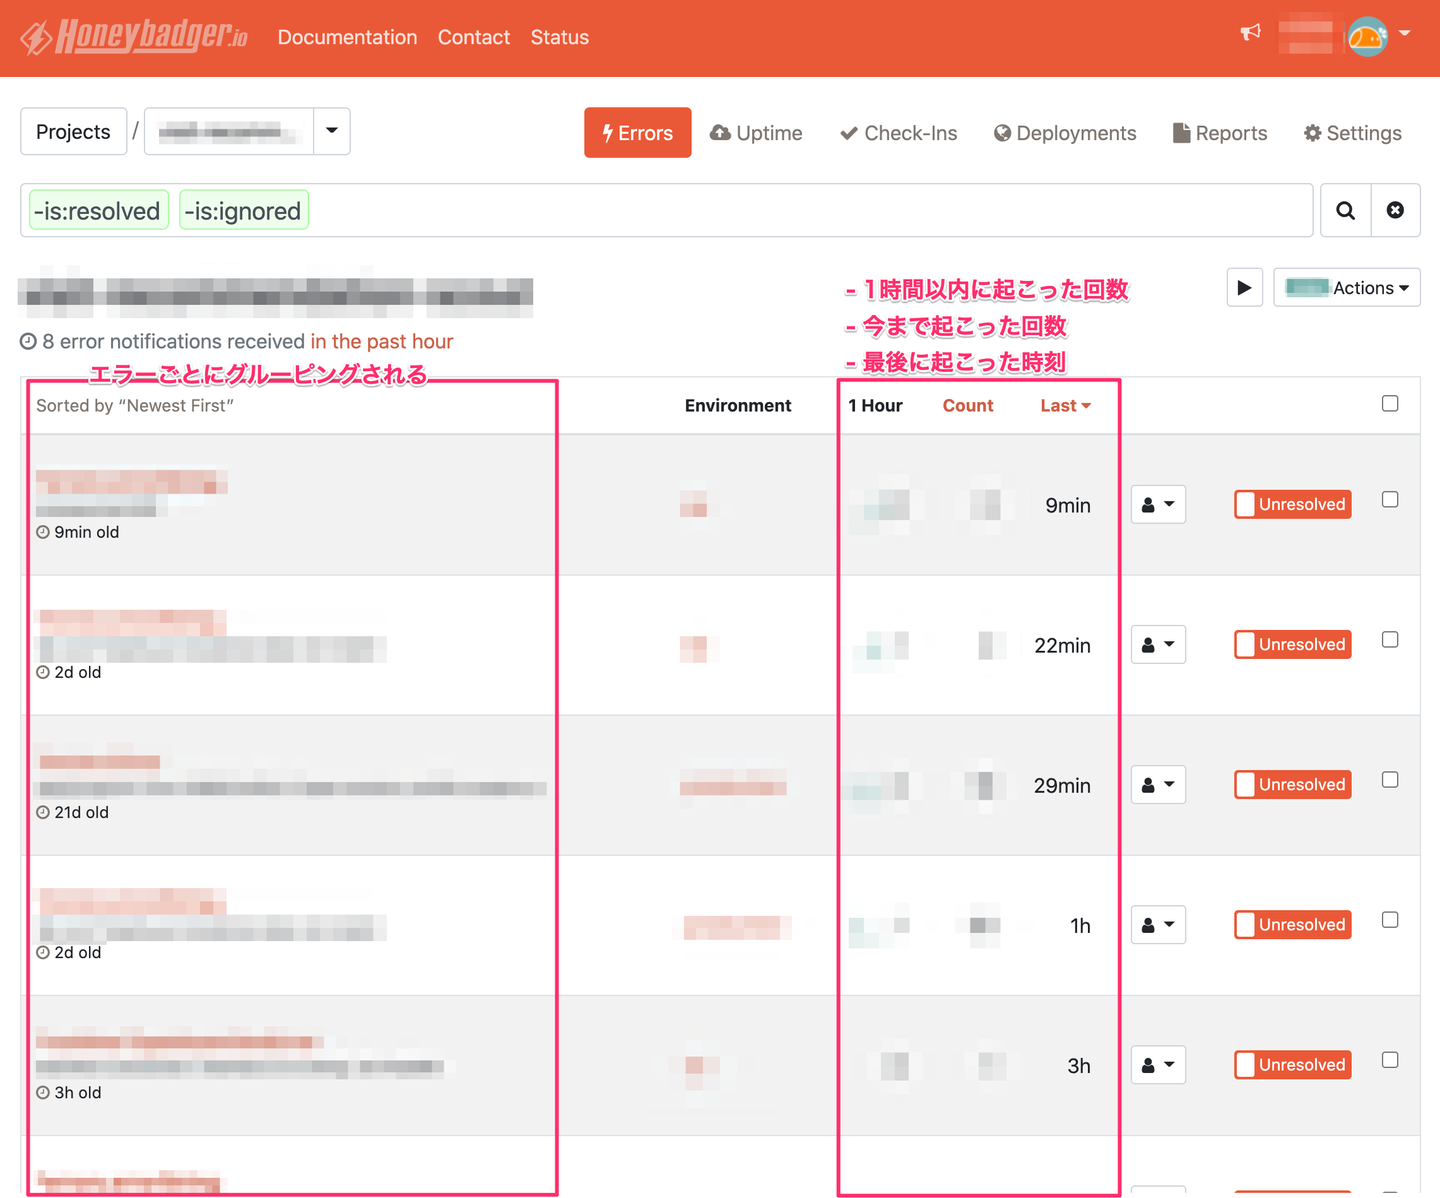
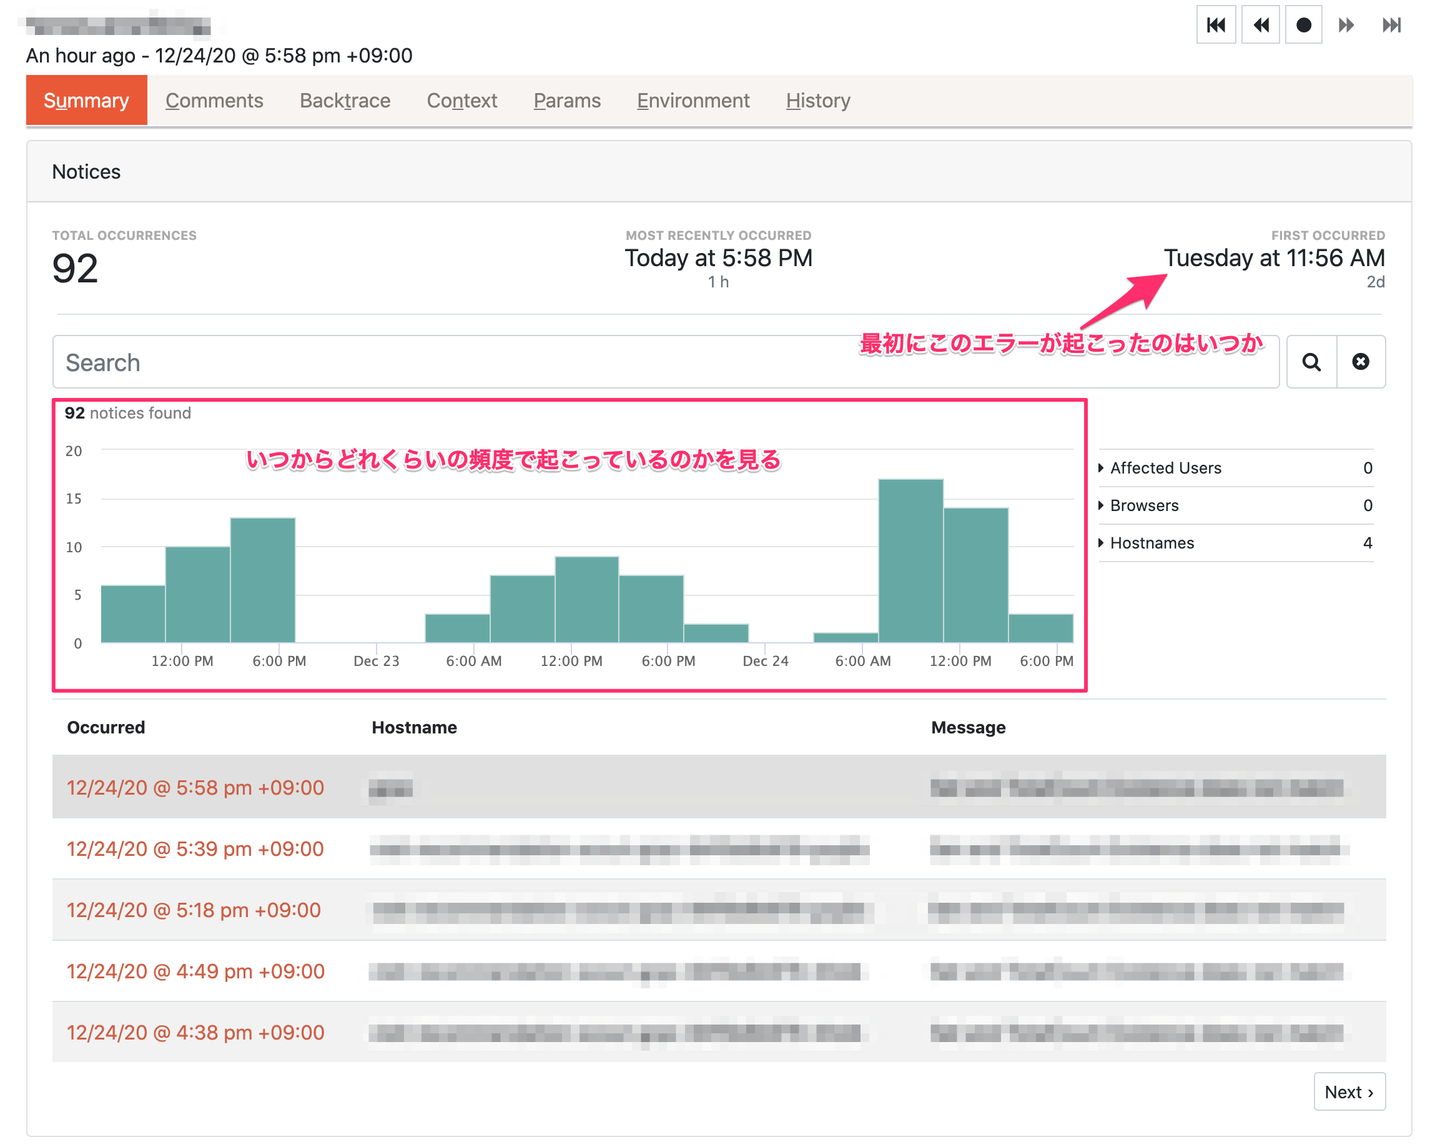
プロジェクトを選択すると以下のようなプロジェクト内で起こったエラー一覧が表示される画面に遷移します。ここでは同じ内容のエラーがグルーピングされて表示されるようになっていて、今までに起こった回数や1時間以内に起こった回数などをざっくり把握することが出来ます。この画面でよく見るのは1時間以内に大量にエラーが出ているかどうかで、もし大量に出ているエラーがあればそれを選択して詳細画面へ行きます。
各エラーの詳細画面は以下のようになっています。例えばある特定の時刻からエラーが急増していることを発見し、その時刻付近に起こったイベント(e.g. デプロイ、DB の障害)を紐付けて仮説を立てていくようなことをよくやります。これは Honeybadger ではわからないので、Datadog、New Relic を見て調査する。障害の主な原因(トリガー)のひとつかつさっと確認出来ることとしてアプリケーションのデプロイが挙げられるので、とりあえず調査の初手はデプロイ履歴を確認するようなことをよくやります。
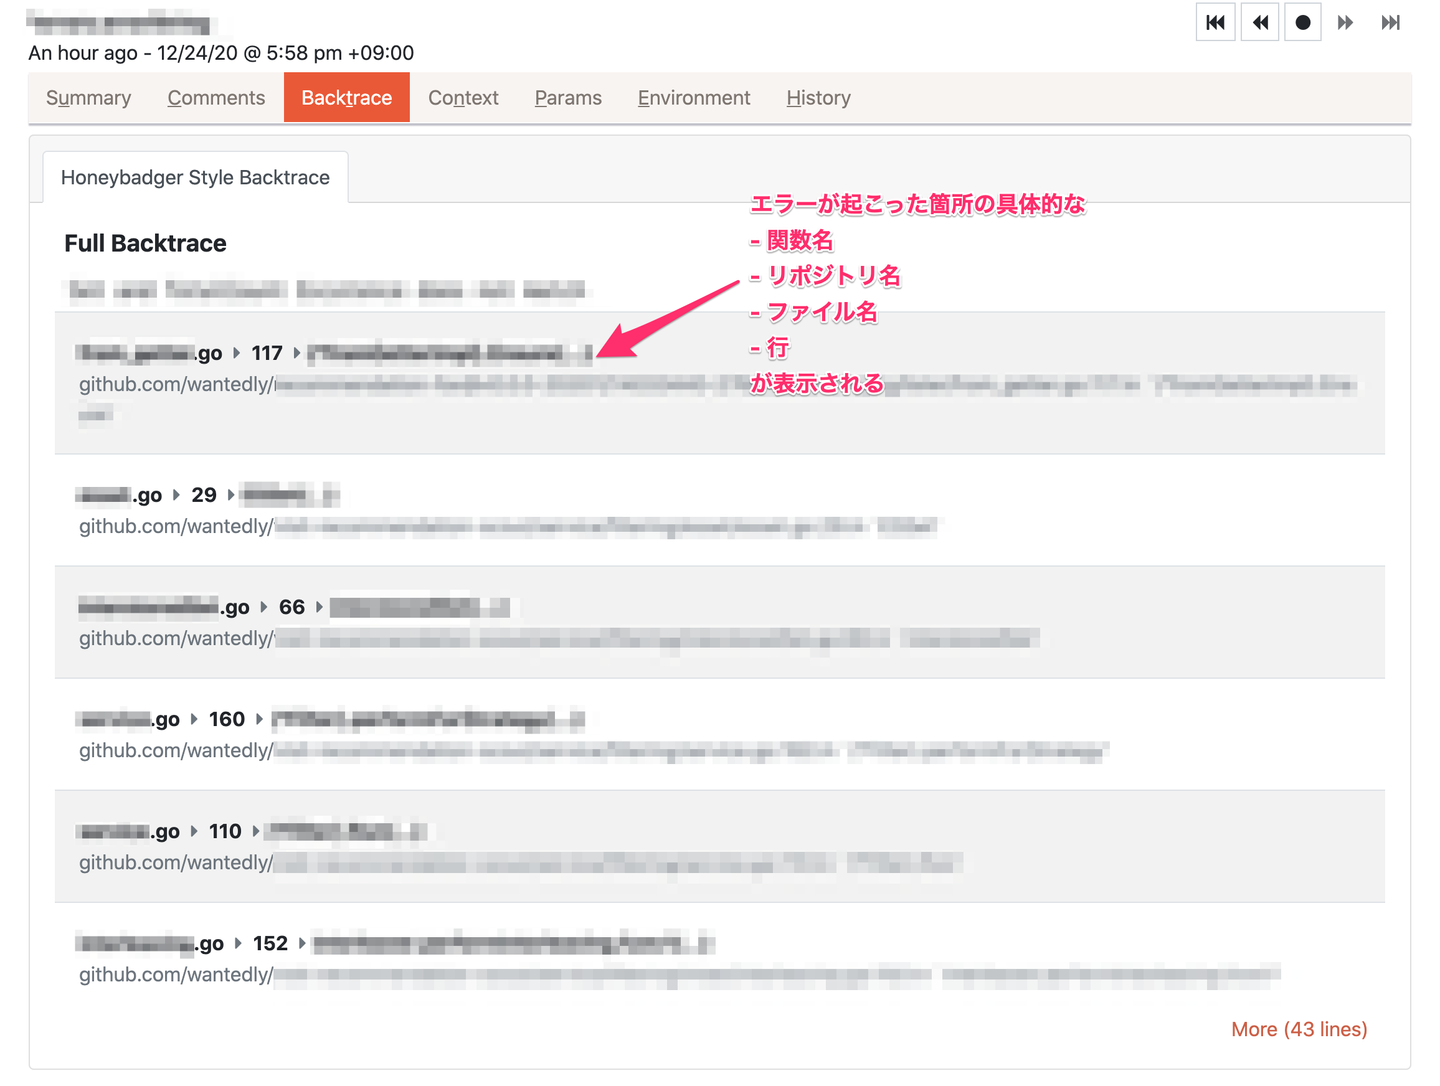
具体的にコード上のどこでエラーが発生したのかはバックトレースで確認します。
Datadog
クラウド時代のサーバー監視&分析サービス | Datadog
Wantedly において何をするために使われているか
主にインフラレイヤのミドルウェア(or 任意)のメトリクスを記録・観測するために使われています。また、メトリクスの変化を元に事前に決められたしきい値を超えたことを検出してアラートを発火させることも行っています。
使い方
以下にいくつかよく使う機能について書いていますが、どの画面でも選択したパラメータが URL に追加されていくようになっているので実質パーマリンクとして機能します。このため、障害対応時に何かしらのメトリクスを観測したとき自分の考察・解釈とは別に観測した事実として Datadog のスクショと URL を Slack や GitHub の Issue に貼り付けるということを意識してやっています。
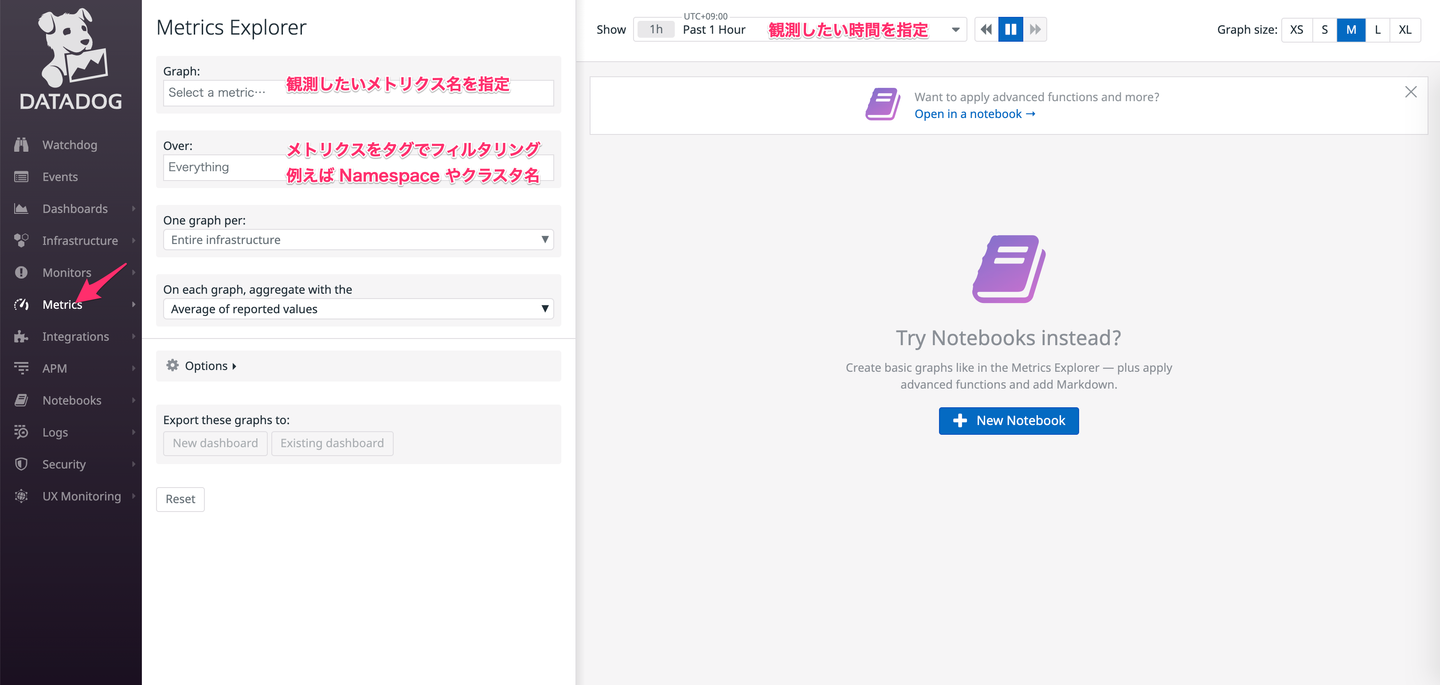
- Metrics→Explore
- Datadog が記録しているメトリクスを絞り込んで時系列で表示する一番基礎的な機能
- Dashboard になっていなかったり、新しく追加したメトリクスはここで確認する
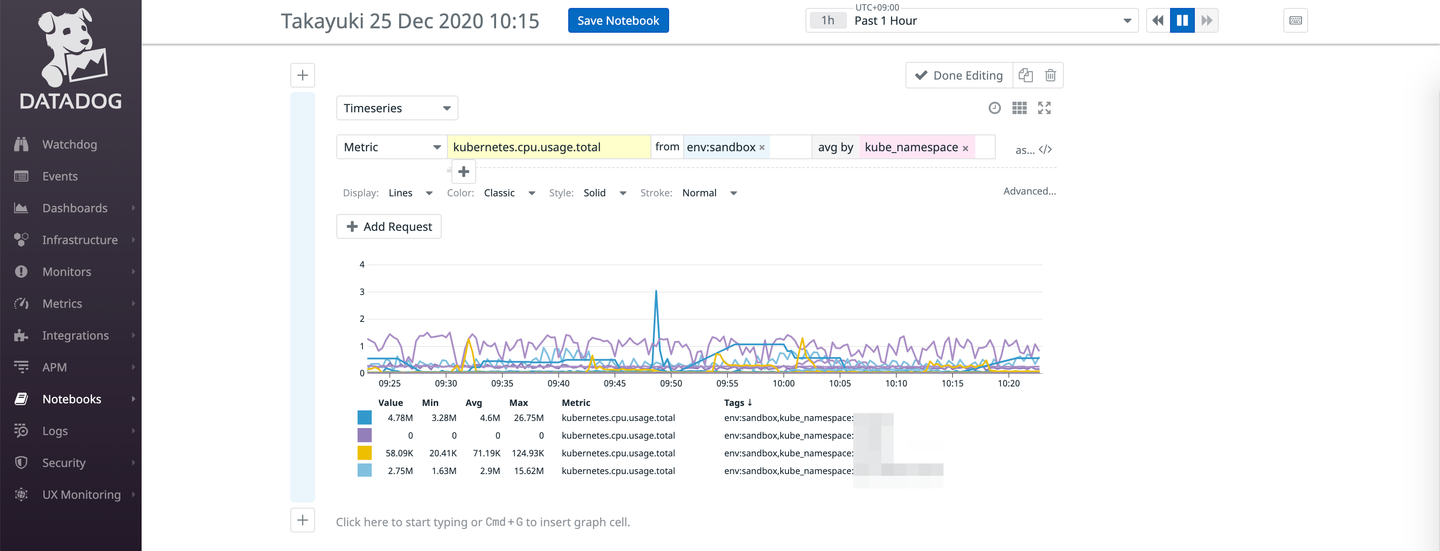
- Notebooks
- Metrics→Explore で観測出来るメトリクスを複数組み合わせたり、Datadog が用意している便利な関数(Timeshift や Forecast など)を適用して複雑なグラフを作ってそれを保存、他人と共有するために使う
- Dashboards
- グラフの配置が柔軟に出来たり、各グラフのパラメータの一括設定が出来るより高機能な Notebook のようなもの
- すでに過去のインフラチームやエンジニアが観測したいプロダクト、ミドルウェアごとに作っている
- おおよそ必要なものはすでに揃っているので新しくプロダクトとかミドルウェアを導入するとかしない限り作る機会は少ない
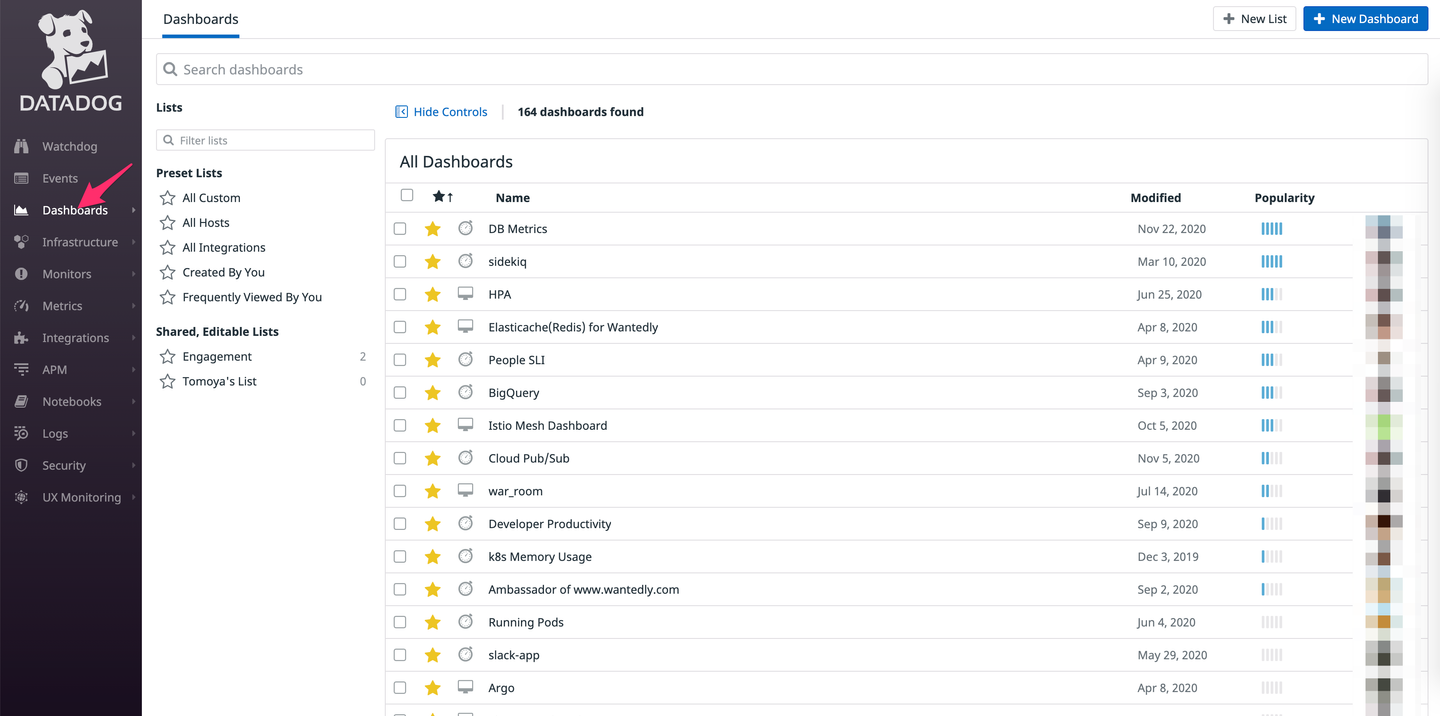
エンジニアは主に Dashboard 単位でメトリクスを観測する。以下はよく見る Dashboard
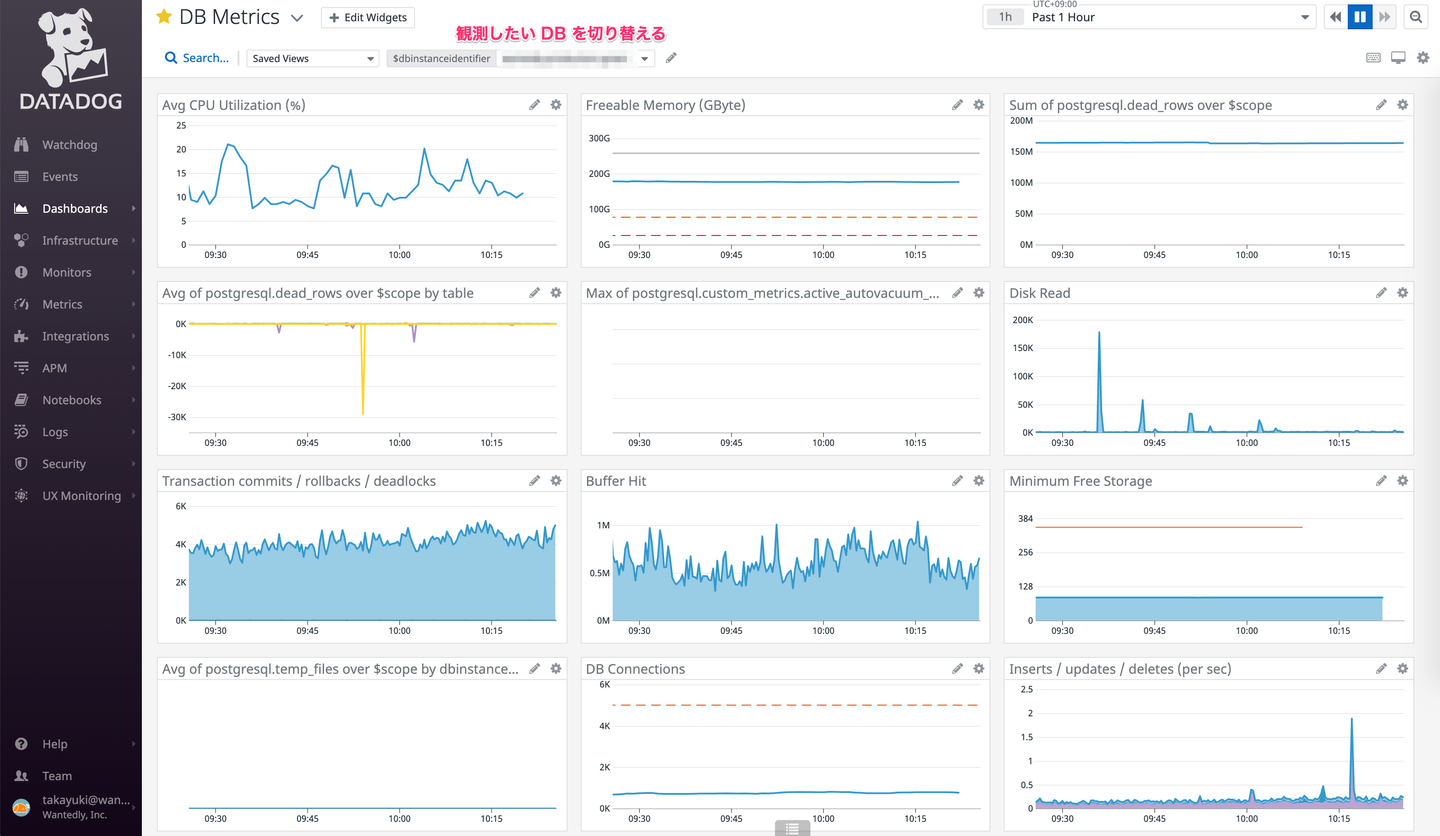
- DB Metrics
- AWS の RDS(PostgreSQL) の各種メトリクスが観測出来る
- BigQuery
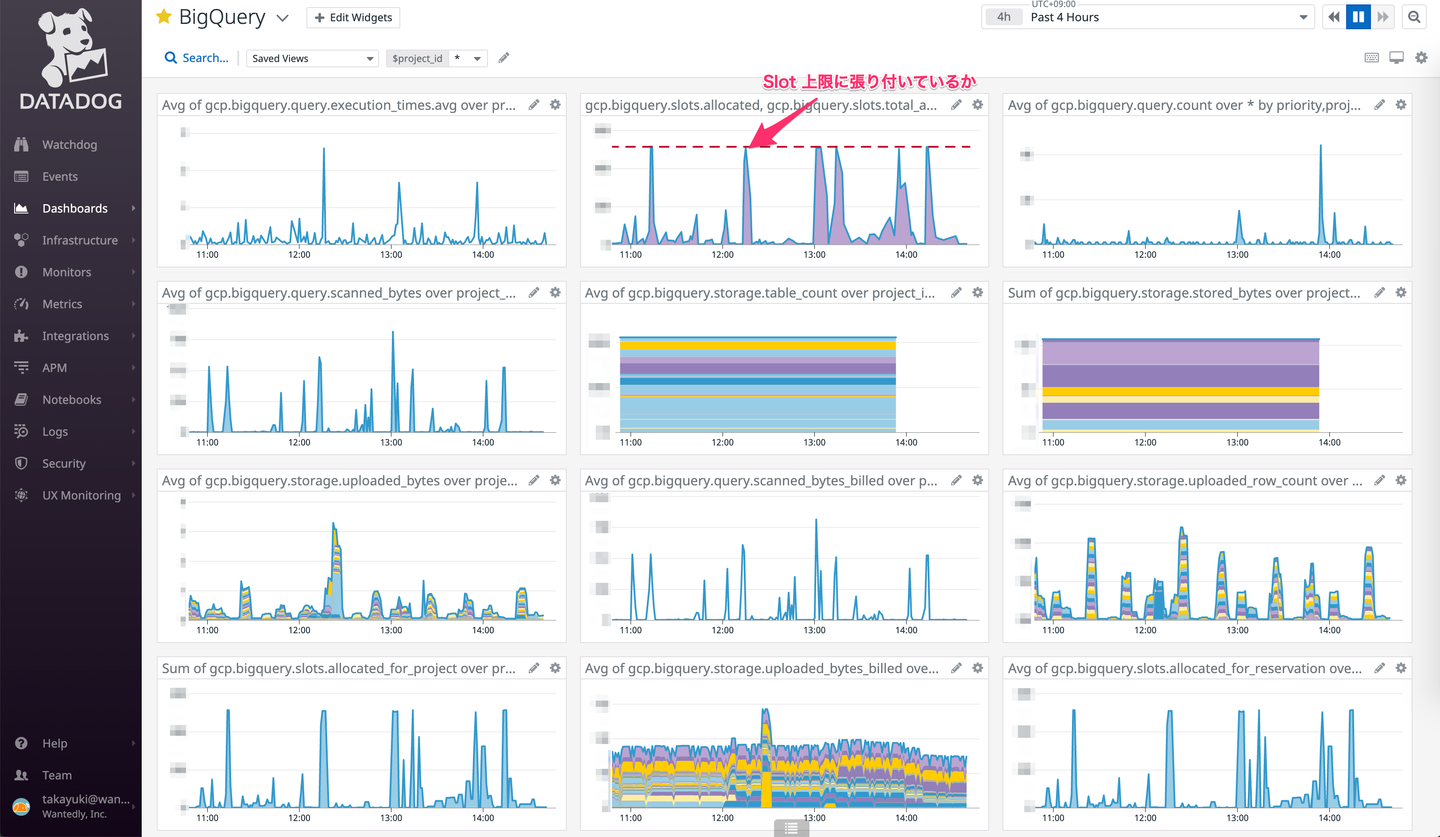
- Wantedly では BigQuery の定額プランを契約しているものの同時に使えるリソース(Slot)は有限なのでそれらのリソースを観測するために使う
- BigQuery が重いと感じたら Slot を使い切ってる可能性があるので確認してみると良いかもしれない
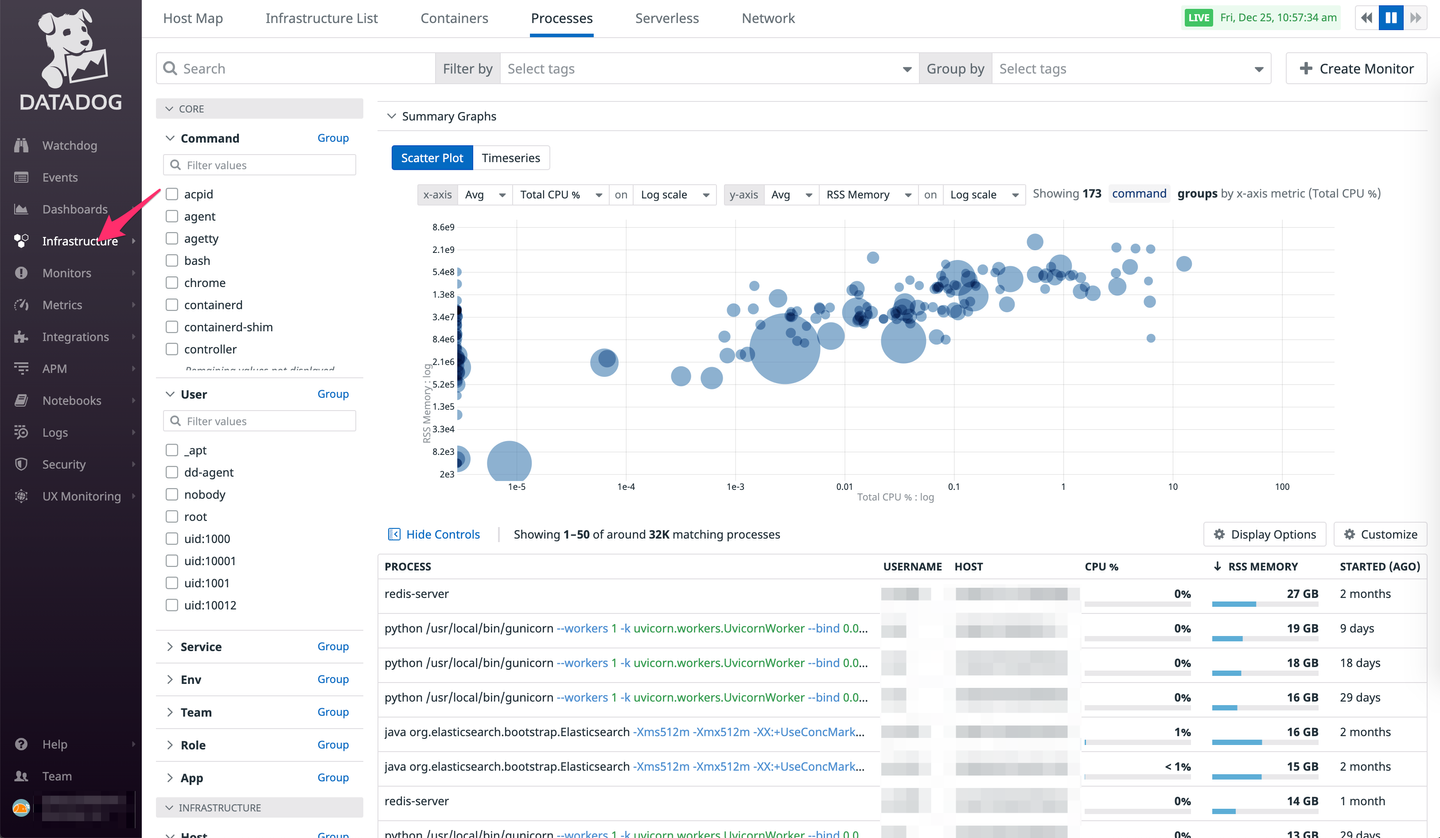
- Infrastructure→Processes
- あんまり知られてない気がするけど個人的な推し機能
- Kubernetes の Pod(Container) 内で実行されているプロセス名(コマンド)ごとに CPU やメモリといったリソースの消費量が可視化出来る
- もし最近 OOM killer で殺されることが多いなと思ったらこれでどの時間帯にどのプロセスがリソースを大量に消費しているのか調査出来たりする
Kubernetes

プロダクショングレードのコンテナ管理基盤
Kubernetesとは何か?
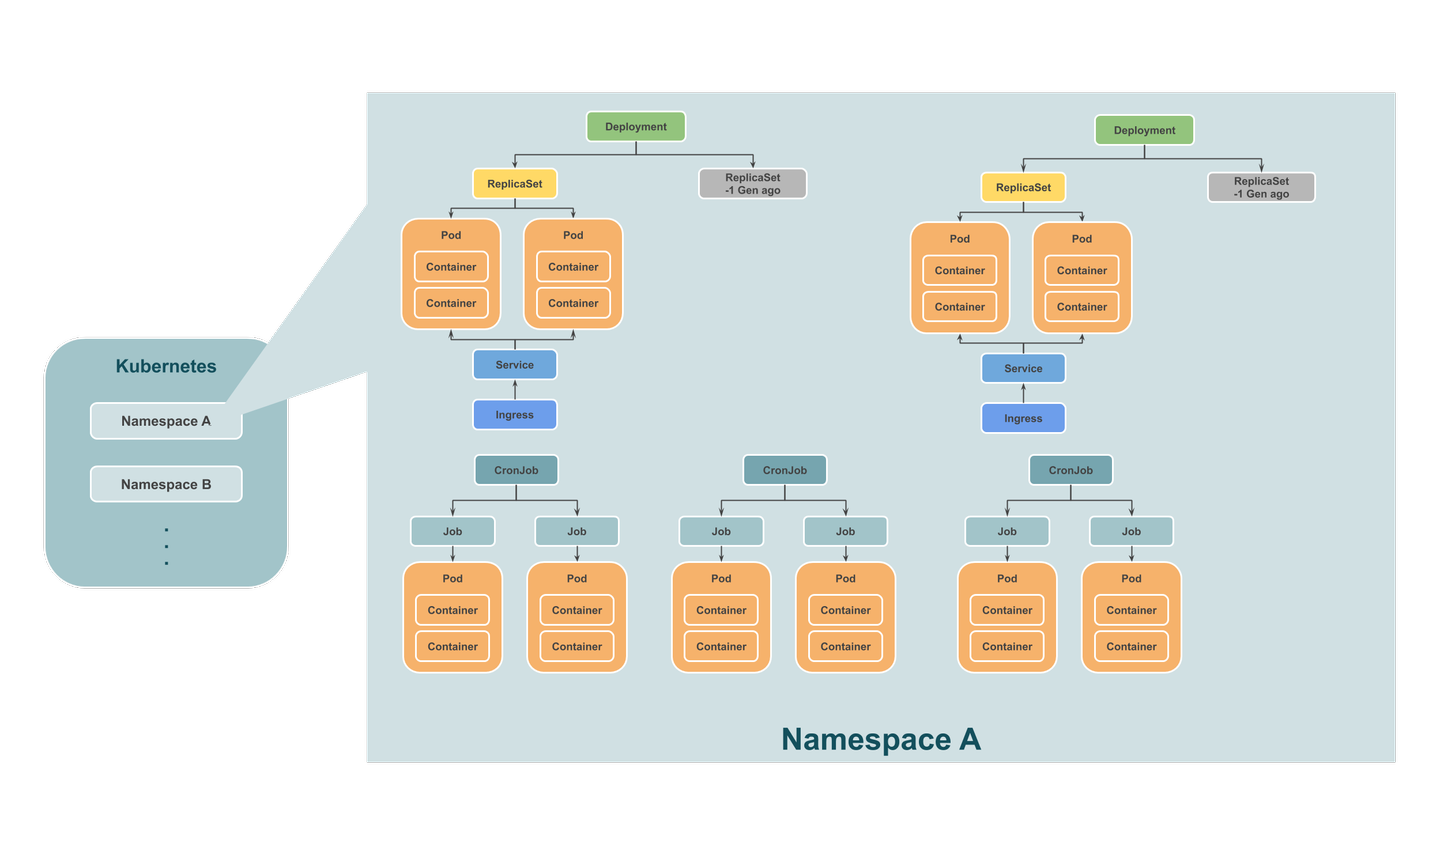
個人的な考えだとインフラエンジニア以外が知っておくと便利なのは Kubernetes における代表的な Object の階層構造と役割(機能)だと思ってます。
Object とは
Kubernetes 以下のレイヤのリソース(Container, Network, Storage, etc…)を抽象化したものを指します。詳細は以下のドキュメントを参照してください。
Kubernetesオブジェクトを理解する
もしくは少し古いですが(約2年前)以下の記事群も図解多めでわかりやすいです。全て読んだというわけではないですが、基本的な概念を解説しているだけなので内容的に deprecated なものはあまりないという認識です。

Kubernetes道場 Advent Calendar 2018 - Qiita
また、Object には spec(仕様)と state(状態)が存在しています。Kubernetes の根本的なコンセプトとして Reconciliation Loop によって Object で宣言された spec(desired state) に操作対象リソースの state を近づけるというものがあり、例えば Pod を2つ立てておいてくださいと spec に書いている状態で Pod が1つになってしまった(state)ら自動的にもう一台 Pod を立てるということを勝手にやってくれます。この辺りに興味があればKubernetesのしくみ やさしく学ぶ 内部構造とアーキテクチャー(読むならp21までで良い)を参照すると良いと思います。
よく聞く主なObject の役割(機能)
- Namespace
- 操作権限の境界
- Object のグルーピング
- ClusterRole(Binding) とか一部の Object 以外は必ずどこかの Namespace に所属しているNamespace が指定される
- Object の作成時に Namespace を指定しなかった場合はdefault
- Pod
- Kubernetes におけるアプリケーションの最小構成単位
- 1つの Pod に N 個の Container が含まれる
- ReplicaSet
- Pod の管理
- 指定した数の Pod の複製・維持
- 例えば Pod を2台起動して欲しいと宣言しておくと、1台 Pod が終了してもその直後に勝手に1台 Pod を起動して2台構成を維持してくれる
- 逆にこれを逆手にとって強制的に再起動したいときは Pod を delete する。ただこの場合 Pod の台数を維持できなくなる瞬間が存在する(Rolling Update ではないので1台構成とかだったらサービスダウンする)ので、複数台構成になっている前提
- Deployment/ReplicaSet で管理された Pod を完全に削除したいという場合は Deployment/ReplicaSet を削除する
- Deployment
- ReplicaSet の世代管理
- Pod の Rolling Update
- 以前の ReplicaSet までの Rollback
- CronJob
- 指定した時刻に Job を起動する
- Job
- Pod を起動して指定された One Shot なコマンドを実行する
- Service
- Pod への通信を管理する
- Pod に対する L4(TCP/IP) Load Balancer
- Pod に対して通信しようと思ったら Service を追加しなければならない
- Ingress
- Pod(Service) への通信を管理する
- Pod(Service) に対する L7(HTTP) Loadbalancer
- URL 上の Path でルーティングを切り替えるとかはこのレイヤでないと出来ない
- この Object が実際に操作するのは Cloud Provider の Load Balancer が多い(Wantedly では ALB)
- 他にも Kubernetes 内の Object も操作できる(e.g. nginx-ingress-controller とか)
Object の階層構造
Argo Workflow

Get stuff done with Kubernetes
Argo Workflow とは?
複数の Job の依存関係を上手く解決・実行してくれる Workflow Engine の1つです。他にも有名どころだと Airflow や Luigi, Digdag などがあります。Argo Workflow の特徴的な点としては、Job の依存関係(DAG)を Python や DSL ではなく、Kubernetes の Custom Resource として YAML 形式のマニフェストファイルで表現するというものがあります。
昨年、推薦周りのフローを実行時刻の前後で表現していた CronJob の依存関係が複雑になりすぎた頃に以下の問題を解決するために導入しました。
- マイクロサービス間を超えた非同期ジョブの依存関係を表現する方法がない
- データ量が増加した等で1つの Job の実行時間が延長した場合、それに合わせて後続の Job の実行開始時刻を全てずらす必要がある
- Job 間に新しい Job を挿入する必要がある場合、後続の Job の開始時刻をどれだけの時間ずらす必要があるのか1つ1つ検証する必要がある
- 各 Job の実行のトリガーが1つ前の Job が完了したかどうかではなく、指定された時刻になっているため1つ前の Job が失敗していたとしても(Job内に失敗を検知する仕組みがない場合)後続の Job が実行され予期しない動作が行われる可能性がある
- 依存関係がリポジトリに設定ファイル・コードとして保管されていない(暗黙知化)
- CronJob 単体ならマニフェストファイルがリポジトリに存在しているが、その実行順序や依存関係の概要は明確に記録されたファイルが存在しないため作った本人または近しい関係者にしかわからない
- 依存関係を俯瞰出来ない
- 依存関係が暗黙知となっているので、依存関係においてどこまで成功していてどこから失敗しているのかが一見してわからない
社内における Argo 実行基盤アーキテクチャ
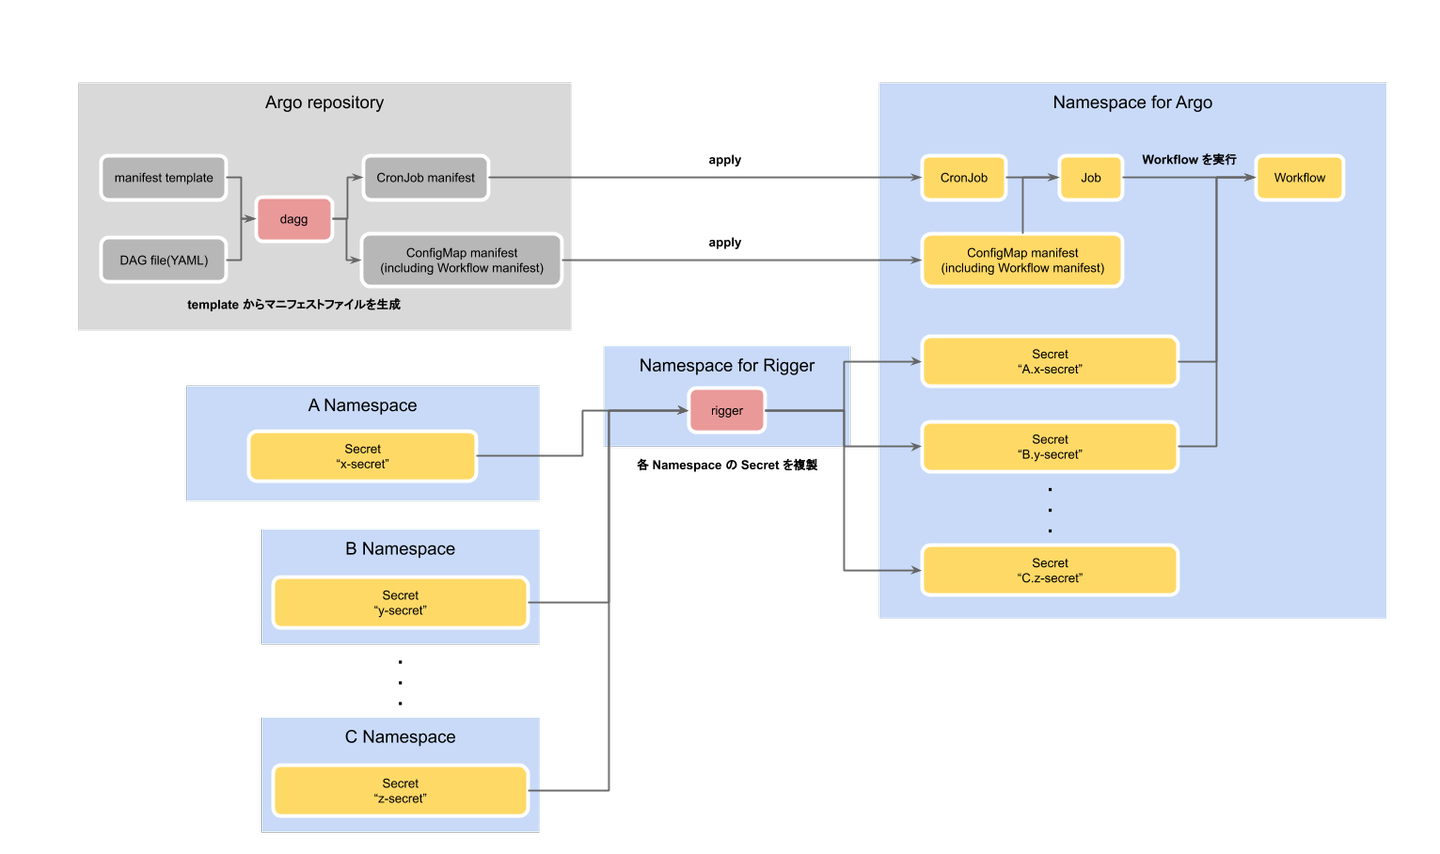
社内環境とユースケースにフィットさせるために小さなツールを自作しつつ、以下のようなフローで Workflow を実行しています。
作ったツール
- rerost/dagg
- Argo Workflow のマニフェストファイルのジェネレータ
- Argo Workflow のマニフェストファイルが複雑で手動で書くのは大変なので、必要な Placeholder だけ定義してそこに値を流し込むということをしている
- wantedly/rigger
- 複数の Namespace に存在する Secret(トークンやパスワードのような機密情報)を1つの特定の Namespace に集約するためのソフトウェア
- Argo で扱う Workflow は複数の Namespace に所属する Job を利用するので、それらの Job が必要とする Secret を1つの Argo を実行している Namespace に集約する必要がある
- ただ権限を Pod ごとに適切に割り当てれば出来るらしい(未検証)ので必要無くなるかも?
Workflow を実行するまでの流れ
- Workflow のマニフェストファイルテンプレートを用意する(これはリポジトリ内に事前に作成されている)
- Argo で実行したい Container Image とコマンド、依存先の Job の内容記述したを DAG file と呼ばれる dagg のテンプレート内パラメータを設定するための YAML ファイルを作成する
- マニフェストファイルテンプレートと DAG file を指定して dagg を実行し、Workflow マニフェストとそれを Kick するための CronJob を Kubernetes 上に作成する
- 事前に rigger が複製していた Secret をマウントして Workflow を実行する Job を Kick
- Workflow が実行される
まとめ
この記事では、チームの Data Scientist 向けにインフラ速習会を行った背景・モチベーション、実際に話した内容について書きました。後日参加していた Data Scientist が共有した知識を実際に使っていたり、社内の他チームからもポジティブなリアクションがあったことを観測していて、自分の持っている知見を共有することで多少なりとも社内の能力向上に貢献出来たと私自身のモチベーションアップにもつながりました。
最後に、このような社内で行われている取り組みについてオープンにすることで、社外のエンジニアや学生の方に Wantedly のエンジニアについて興味を持っていただけたら嬉しいです。

/assets/images/7052304/original/49100b17-5866-4cec-b50b-a37ea73565e9?1638782149)