ウォンテッドリーで Infra Squad としてインフラエンジニアをしている @fohte です。
ウォンテッドリーでは最近、生成 AI をプロダクトに組み込む取り組みが増えています。たとえば、転職 AI アプリ「Mendy」、AI が候補者リストを作って提案する「AI エージェントモード」、AI との対話で募集を探せる「キャリア AI エージェント」をリリースしました。

新アプリ「Mendy」を提供開始|一人ひとりに寄り添う「転職AIエージェント」 | Wantedly, Inc.

AIが候補者リストを作成提案する「AIエージェントモード」提供開始 | Wantedly, Inc.

AIとの対話で見つける適材適所|「キャリアAIエージェント」をリリースしました | Wantedly, Inc.
これらのリリースを支えるため、Infra Squad では社内のプロダクトから Amazon Bedrock を利用するための仕組みづくりをしました。
ひとえに Bedrock を利用する基盤といっても、モデルの呼び出し方や料金体系、利用上限 (quota) の種類など、知っておくべきことは多くあります。この記事では、まず Bedrock をプロダクトに組み込む前に押さえておきたい quota についてまとめます。次回以降の記事では、コストのトラッキングや、各チームの Bedrock の呼び出し方を揃えるための規約についても触れます。
- 利用上限編 (この記事)
- コストトラッキング編 (今後公開予定)
- 仕組みの標準化編 (今後公開予定)
Bedrock にはどんな上限があるのか
Bedrock には、モデルを呼び出せる量の上限 (quota) がいくつかあります。上限を超えた呼び出しはエラーになり、上限は申請しても引き上げられるとは限りません。そのため Bedrock をプロダクトに組み込むなら、いつか quota を超えることを前提に設計しておく必要があります。
quota の種類と単位
Bedrock のモデルをオンデマンドで呼び出すときにかかる quota には、次の 3 種類があります。
- TPM (tokens per minute): 1 分あたりに処理できるトークン数
- RPM (requests per minute): 1 分あたりに送れるリクエスト数
- TPD (tokens per day): 1 日あたりに処理できるトークン数
TPM と RPM はモデルとリージョンの組み合わせごとに、TPD はモデルは共通でリージョンごとに決まっています (参考: Quotas for the bedrock-runtime endpoint)。また、それぞれの quota は別々にかかります。たとえば、1 分あたりの量が TPM に収まっていても、それが続けば TPD を超えても呼び出しはエラーになります。
デフォルトの値は、たとえば次のとおりです (2026 年 10 月時点、全リージョン共通。TPM は後述の cross-region inference で呼び出すときの値。参考: Amazon Bedrock endpoints and quotas)。
- Claude Opus 5.5 の TPM: 3,000 万
- Claude Sonnet 5.5 の TPM: 600 万
- TPD (全モデルの合計): 7 億
なお、quota の種類や単位は変わることがあります。実際、現在は TPD が全モデルの合計となっていますが、少し前まではモデルごとに別枠となっていました。本記事は 2026 年 10 月時点の情報ですが、生成 AI を取り巻く状況は変化が早く、Bedrock も新しいモデルが追加されるなどして quota の値や種類が変わることがあります。設計の前提にした quota は、ときどきドキュメントで確かめ直すとよいでしょう。
引き上げは申請できるが、すぐに通るとは限らない
quota の引き上げは申請できますが、大きな引き上げは審査と反映に時間がかかります (参考: Requesting a quota increase (Service Quotas))。さらに Bedrock のドキュメントには次のように書かれており、必ずしも引き上げが通るとは限りません。実運用開始前に、余裕をもって申請しておくのがよいでしょう。
Due to overwhelming demand, priority will be given to customers who generate traffic that consumes their existing quota allocation. Your request might be denied if you don't meet this condition.
(日本語訳) 需要が非常に多いため、既存の quota を使い切るトラフィックがある利用者を優先します。この条件を満たさない場合、申請は却下されることがあります。
出典: Quotas for the bedrock-runtime endpoint - Amazon Bedrock
quota を超えても呼び出しを続けるにはどうするか
前述のとおり、quota はアカウントと送信元リージョンの組み合わせごとに別枠です。つまり、あるリージョンで上限を超えても、別のリージョンや別のアカウントの quota は消費されません。
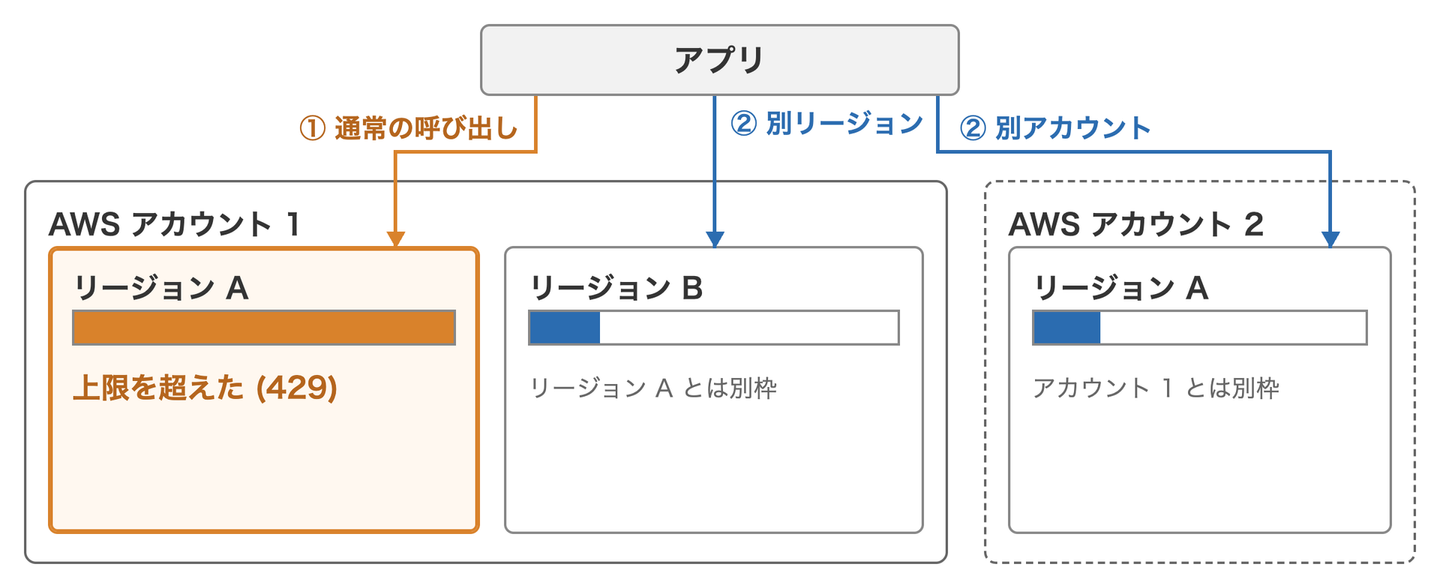
ウォンテッドリーでは、突発的な quota 不足によるエラーを回避するために、呼び出しが quota 超過のエラー (HTTP 429 の ThrottlingException) になったら別のリージョンで呼び出し直す、というフォールバック実装を入れています。
TPM と RPM はモデルごとにも別枠なので、別のモデルに切り替える手もあります。ただし TPD は全モデルの合計なので、TPD を超えたときは別のモデルに切り替えても呼び出せません。また、モデルを変えると出力の質や癖も変わるので、まずは送信元リージョンを分散するか、すでにマルチアカウント運用をしている場合はアカウントを分散することをまず検討するとよいでしょう。
cross-region inference でも quota は送信元リージョンで消費される
Amazon Bedrock でモデルを呼び出すときは、大別して次の 2 つの方法があります。
- モデル (foundation model) を直接呼び出す
- inference profile を使って呼び出す
inference profile は、モデルと、推論を振り分けてよいリージョンを定義したリソースです。呼び出すときは、モデル ID の代わりに inference profile の ID を指定します。inference profile には次の 2 種類があります (参考: Inference profiles)。
- cross-region inference profile: Bedrock があらかじめ用意している profile。複数のリージョンのモデルを束ねていて、Bedrock はその中から推論を実行するリージョンを選ぶ
- application inference profile: 利用者が作る profile。タグを付けてコストを分けたり、使用量を profile ごとに追跡したりするために使う。単一リージョンのモデルからも、cross-region inference profile からも作れる
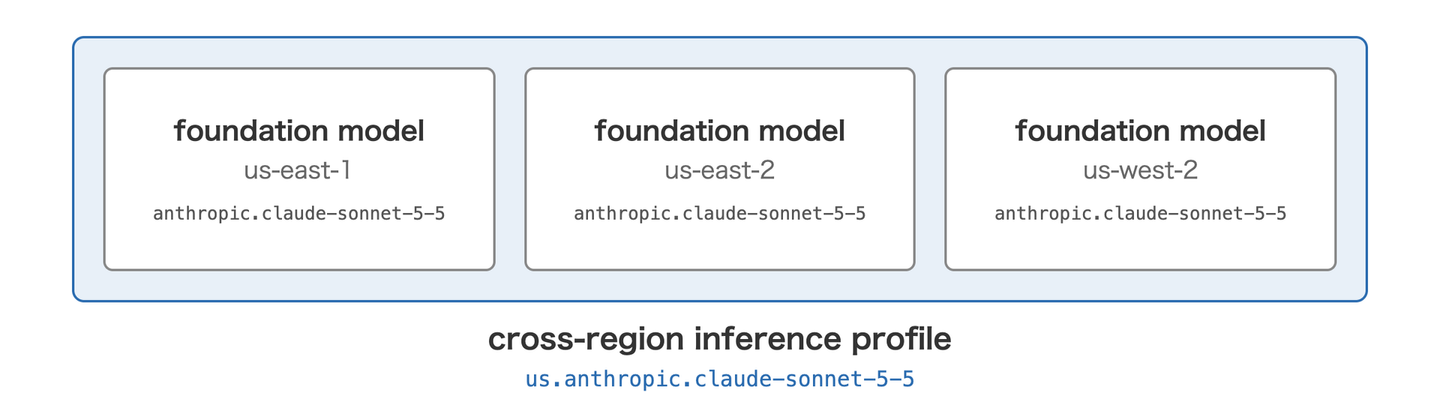
たとえば上の図の Claude Sonnet 5.5 の profile は、us-east-1 から呼び出すと、米国の 3 つのリージョンに推論を振り分けます (参考: Claude Sonnet 5.5 - Amazon Bedrock)。モデル ID が anthropic.claude-sonnet-5-5 なのに対し、profile の ID は地域を表す us. が先頭に付いた us.anthropic.claude-sonnet-5-5 です。
cross-region inference profile には、次の 2 種類があります (参考: Global cross-Region inference)。
- geographic cross-region inference profile: 米国や日本のような地域の中から推論先を選ぶ。データを処理する場所を地域の中に限りたい場合はこちらを使う
- global cross-region inference profile: 世界中の商用リージョンから推論先を選ぶ。推論先の候補が広く、料金も geographic より約 10% 安い
quota は geographic 用と global 用で別の項目です。
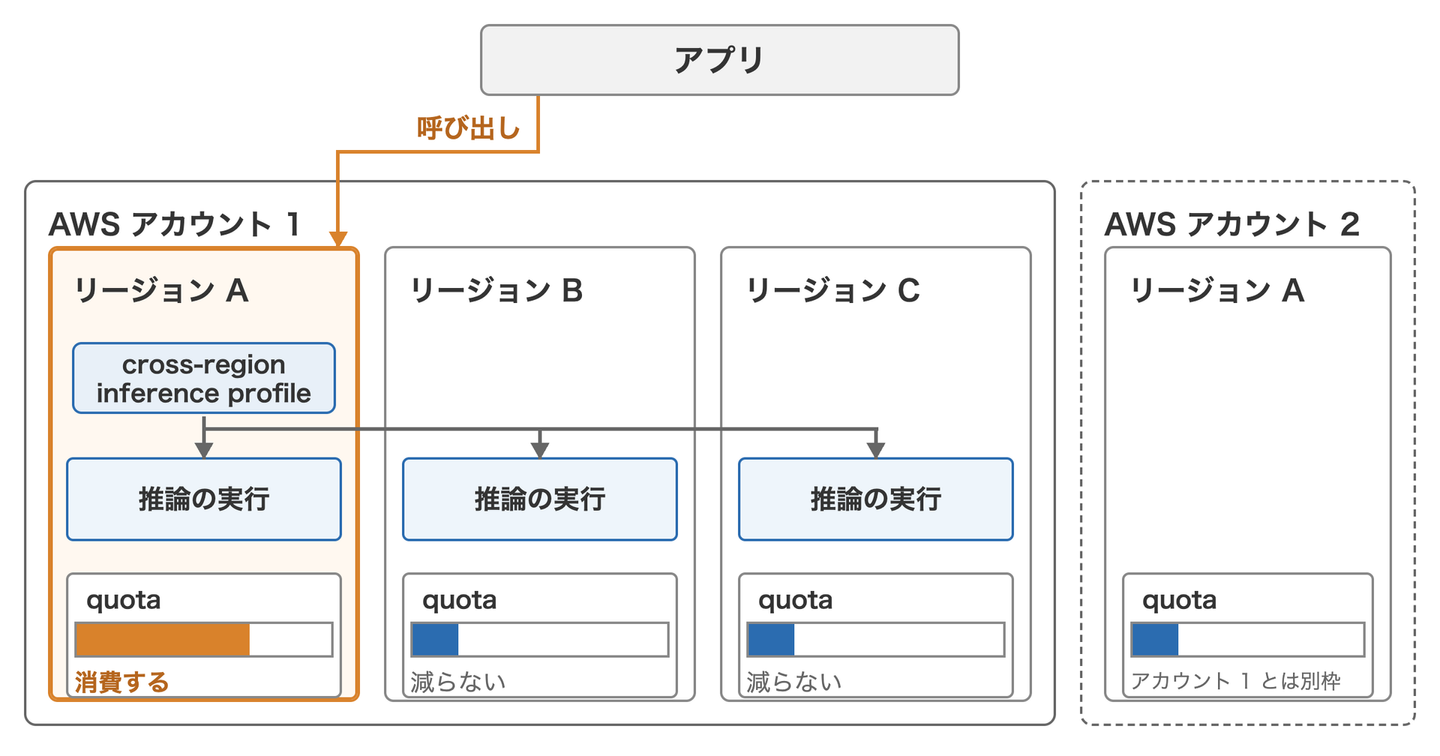
どちらを使っても、quota を消費するのはリクエストを送った送信元リージョンだけです。推論を実行したリージョンの quota は消費されません。そのため cross-region inference を使っていても、送信元リージョンの quota を超えたら、別の送信元リージョンへ切り替える必要があります。
すぐに結果が要らない処理は batch inference に回す
リアルタイムに結果を返す必要がない処理なら、batch inference も選択肢になります。batch inference は、S3 に置いた大量のリクエストを 1 つのジョブとしてまとめて処理する呼び出し方です (参考: Process multiple prompts with batch inference)。
batch inference の quota は、オンデマンドの呼び出しとは独立しています。TPM と RPM は Converse や InvokeModel のようなオンデマンドの呼び出しにかかる quota なので、batch inference では気にしなくて済みます (参考: Amazon Bedrock endpoints and quotas)。代わりに、ジョブあたりのレコード数や同時に実行できるジョブ数に quota があります。なお、TPD が batch inference にもかかるかは、ドキュメントに書かれていません。
料金も、Claude を含む一部のモデルではオンデマンドより 50% 安くなります (参考: Amazon Bedrock pricing)。
ただし、batch inference に対応していないモデルもあります。2026 年 10 月時点では、Claude Opus 5.5 と Claude Sonnet 5.5 は対応モデルに含まれていません (参考: Supported Regions and models for batch inference)。ウォンテッドリーではまだ batch inference を使った事例はありませんが、夜間にまとめて処理するような用途では、オンデマンドの quota を圧迫しない手段として検討する価値があります。
quota に近づいたこと、超えたことにどう気付くか
ここまでどういった quota が存在するのかを書いてきましたが、実際に Bedrock を使うときは quota に近づいたことや超えたことにどう気付くかという監視設計が重要です。ここでは、使い始める前の見積もりと、稼働後の監視についてまとめます。
事前に quota を引き上げるべきか検討する
本番稼動後に quota が不足して引き上げが必要となっても、前述のとおり AWS サポートに申請してもすぐに通るとは限りません。そのため、事前に見積もって必要であれば引き上げを申請しておきましょう。
ウォンテッドリーでは、Bedrock を新しく使い始める前に、想定されるリクエスト数と 1 リクエストあたりのトークン数から、quota の消費量をざっくり見積もっています。フォールバックは突発的な超過への備えで、通常の利用ではフォールバックが起きない前提で quota を引き上げています。切り替え先の quota にも上限があり、切り替えるたびにレイテンシーも増えるためです。
なお注意しておくべき点として、quota の消費量はモデルによって burndown rate という係数が設けられています。リクエストの開始時には、入力トークン数と max_tokens の合計がいったん quota から差し引かれます。リクエストの終了時に、実際の消費量が次の式で精算され、余った分は quota がリセットされます (参考: How tokens are counted in Amazon Bedrock)。
quota の消費量 = 入力トークン数 + キャッシュ作成入力トークン数 + 出力トークン数 × burndown rateたとえば Claude Opus 5.5 では burndown rate が 10 倍で、出力 1 トークンが quota 上は 10 トークンの消費とカウントされます。burndown rate はモデルによって決まっているため、使うモデルの値は見積もる際にドキュメントで確かめるのが確実です。
また、リクエスト開始時に差し引かれる量は max_tokens で決まるので、max_tokens を実際の出力より大きく設定していると、実際の消費量よりも早く TPM に達します。
消費量の推移を監視する
稼動後には、quota が想像以上に消費していないかや、エラーが発生していないか監視することも重要です。
CloudWatch には、呼び出し回数や入力・出力トークン数のメトリクスがあり、前述の式に当てはめると消費量を計算できます。消費量の目安を示す EstimatedTPMQuotaUsage というメトリクスもありますが、AWS 自身が近似値であり、quota の消費量を判断する唯一の指標にしないよう書いています (参考: Monitor Amazon Bedrock runtime metrics)。
なお application inference profile を使って呼び出す場合は、CloudWatch のメトリクスの ModelId に、モデルの ID ではなく profile の ID が入ります。profile の ID はランダムな文字列で、どのモデルを指しているかはメトリクスからはわかりません。quota は前述のように基本的にモデルごとに決まっているので、消費量はモデルごとに足し合わせて見る必要があります。ウォンテッドリーでは、Datadog の reference tables を使ってモデル名と inference profile の ID をマッピングして集計しています。
また、突発的に quota の消費が増えたときの原因を調べたいなど、1 回ごとの呼び出しを詳しく見たいときは、model invocation logging も使えます。呼び出しのログを S3 や CloudWatch Logs に送る機能で、ログには呼び出したモデルや profile の ID、呼び出し元の IAM ロール、トークン数が含まれます (参考: Monitor model invocation using CloudWatch Logs and Amazon S3)。
ログは次のような JSON です (値は架空のもので、プロンプトと応答の本文は省略しています)。
{
  "schemaType": "ModelInvocationLog",
  "schemaVersion": "1.0",
  "timestamp": "2026-01-01T00:00:00Z",
  "accountId": "123456789012",
  "identity": {
    "arn": "arn:aws:sts::123456789012:assumed-role/example-role/example-session"
  },
  "region": "us-east-1",
  "requestId": "00000000-0000-0000-0000-000000000000",
  "operation": "InvokeModelWithResponseStream",
  "modelId": "arn:aws:bedrock:us-east-1:123456789012:application-inference-profile/abcdefghijkl",
  "input": {
    "inputContentType": "application/json",
    "inputTokenCount": 3000,
    "cacheReadInputTokenCount": 0,
    "cacheWriteInputTokenCount": 0
  },
  "output": {
    "outputContentType": "application/json",
    "outputTokenCount": 30
  },
  "inferenceRegion": "us-west-2"
}
modelId には、メトリクスと同じく application inference profile の ID が入ります。region はリクエストを送ったリージョン、inferenceRegion は推論を実行したリージョンです。
このログから集計することでも消費量の推移は計算できるため、より正確に消費量を把握したい場合は、CloudWatch のメトリクスと合わせてログからの集計も検討するとよいでしょう。
quota を超えたことに気付く
quota を超えたかどうかは、quota 超過で拒否されたリクエストの件数で判断するか、エラートラッキングツールを使ってエラーの発生状況を監視するのがよいでしょう。
監視に使えるメトリクスとして、CloudWatch に呼び出しの失敗をカウントするメトリクスが 2 つあります (参考: Monitor Amazon Bedrock runtime metrics)。
InvocationThrottles: システムがスロットリングした呼び出しの数。SDK のリトライ設定によって件数が変わるInvocationClientErrors: クライアント側のエラーになった呼び出しの数。quota 超過で拒否されたリクエストもここに含まれ、スロットリングとしては数えられない
ただし、InvocationThrottles だけでは quota 超過の件数を正確に数えられません。quota 超過で拒否されたリクエストは InvocationThrottles ではなく InvocationClientErrors に数えられるためです。また AWS SDK は、スロットリングされた呼び出しを自動でリトライします。そのため InvocationThrottles は、アプリケーションから見た失敗の件数とは一致しません。たとえば、リトライの末に成功した呼び出しも数えられますし、1 回の呼び出しがリトライの回数分だけ数えられることもあります。一方の InvocationClientErrors には、quota 超過以外のクライアントエラーも含まれます。
そのためウォンテッドリーでは、ダッシュボードで両方の件数をモニタリングしつつ、quota 超過そのものにはアプリケーションのエラー通知で気付けるようにしています。
最後に
Bedrock を本番に入れる前に押さえておきたい quota についてまとめました。
- Bedrock には TPM、RPM、TPD の quota があり、引き上げはすぐに通るとは限らない
- 上限を超えたら、別のリージョン、アカウント、モデルに切り替えられるようにしておく
- cross-region inference を使っても、quota は送信元リージョンで消費される
- quota に近づいたことや超えたことに気付けるように監視設計しておく
Bedrock をプロダクトに組み込むなら、quota を超えることを前提に設計しておくのが大切です。Bedrock を本番で使おうとしている方の一助となれば幸いです。


/assets/images/7052304/original/49100b17-5866-4cec-b50b-a37ea73565e9?1638782149)