生成AIを使えば、自然な言葉でデータを分析したり、社内文書から必要な情報を探したりできるようになってきました。
例えば、
「どの機能でエラーが多い?」
「過去に似た問い合わせはあった?」
といった質問にも、AIが答えてくれるような仕組みを作れます。
しかし、実際の企業では、その前に大きな問題があります。
「そもそも、必要なデータがどこにあるのか分からない」
という問題です。
会社には、売上情報、システムログ、問い合わせ履歴など、さまざまなデータが蓄積されています。
せっかくデータがあっても、どこに何が保存されているのか分からなければ、分析やAI活用につなげられません。
そこで今回は、AWSの「Amazon SageMaker Catalog」を使って、データを整理し、生成AIによる分析や検索につなげる仕組みを試してみました。
データがたくさんあっても、使えるとは限らない
例えば、あるシステムで「レポート画面の表示が遅い」という問題が発生したとします。
原因を調べるには、システムのアクセスログを分析する必要があります。
しかし、
「アクセスログはどこに保存されている?」
「処理時間はどの項目に記録されている?」
「エラーを調べるには何を見ればよい?」
といったことが分からなければ、分析を始めることもできません。
こうした問題を解決する仕組みが「データカタログ」です。
データカタログは、簡単に言えばデータの目次のようなものです。
図書館で本を探すとき、タイトルや分類から目的の本を見つけられますよね。
データカタログも同じように、
「どこに保存されているか」
「どんな情報が含まれているか」
「何のために使えるデータなのか」
を整理して、必要なデータを見つけやすくします。
SageMaker Catalogでデータを整理してみた
今回利用したのは、AWSの「Amazon SageMaker Catalog」です。
データの保存場所や内容、利用目的などを登録し、必要なデータを探しやすくする仕組みです。
今回は、SaaSサービスを想定して、2種類のサンプルデータを用意しました。
① アクセスログ:400件
システムの各機能について、処理時間やHTTPステータスコードなどを記録したデータです。
② 問い合わせ文書:15件
「レポート画面が遅い」「画面が固まる」といった、ユーザーからの問い合わせを想定したデータです。
アクセスログのような数値中心のデータと、問い合わせのような文章中心のデータ。
この2種類をカタログに登録し、それぞれの内容や利用目的を整理しました。
ポイントは、データの保存場所だけでなく、そのデータが何に使えるのかまで登録することです。
例えば、アクセスログであれば、「システムの機能ごとの処理時間やエラー率を分析するためのデータ」
と説明しておきます。
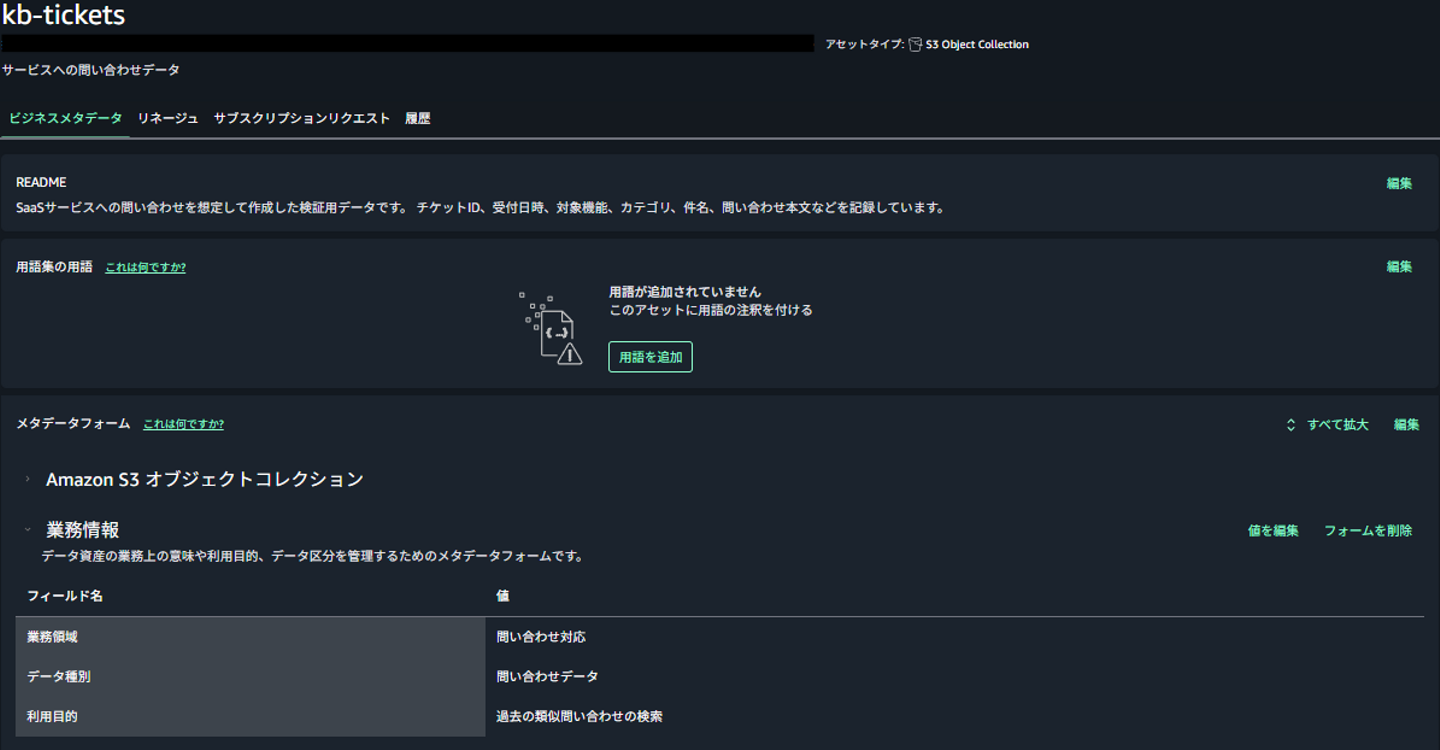
これによって、初めてデータを見る人でも、何のためのデータなのか判断しやすくなります。
検証①:自然な言葉でアクセスログを分析する
まずは、登録したアクセスログを使って分析してみました。
今回は「SageMaker Data Agent」と「Amazon Athena」を組み合わせています。
SageMaker Data Agentは、自然な言葉からSQLなどを生成できる機能です。
SQLとは、データベースから必要な情報を取得したり、集計したりするための言語です。
通常は分析したい内容に合わせてSQLを書く必要がありますが、今回はAIに次のように依頼しました。
「機能ごとの平均処理時間を計算し、長い順に表示してください」
すると、AIがSQLを生成しました。
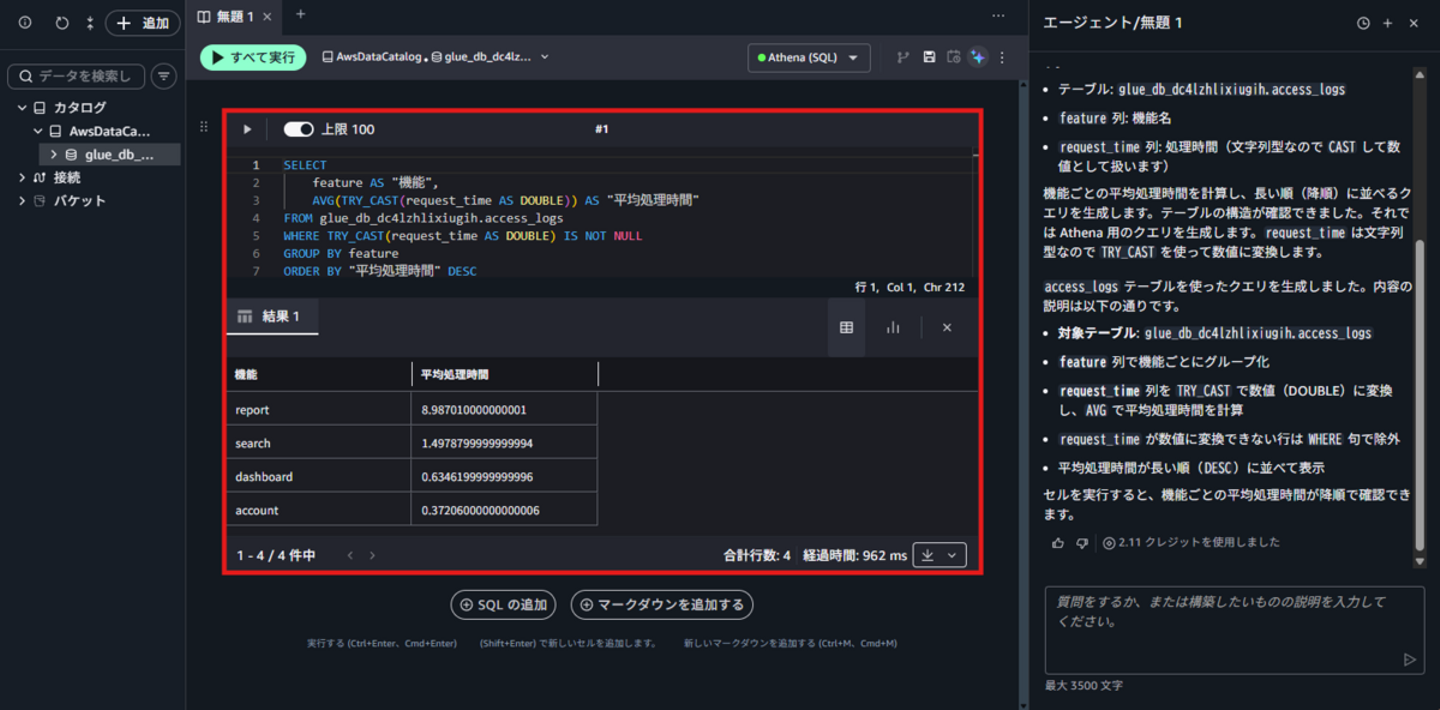
そのSQLを確認してAthenaで実行した結果がこちらです。
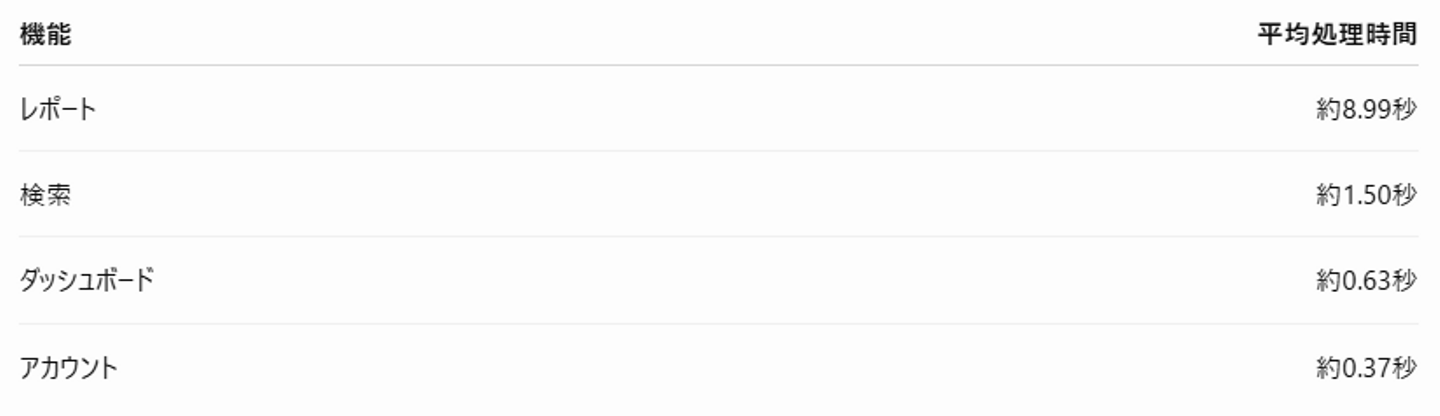
レポート機能の処理時間が、ほかの機能より長いことが分かります。
さらに、
「ステータスコード500以上をエラーとして、機能ごとのエラー率を表示してください」
と依頼すると、レポート機能のエラー率が15%と、こちらも最も高い結果になりました。
つまり、今回のサンプルデータでは、レポート機能に性能上の問題がありそうだと判断するための情報を得られました。
自然な言葉で分析内容を伝え、AIが生成したSQLを確認して実行する。
こうした方法で、データ分析を進められることが確認できました。
検証②:言葉が違っても、似た問い合わせを探せる?
次に試したのは、問い合わせ文書の検索です。
例えば、ユーザーから、
「レポート画面が固まり、タイムアウトすることがあります」
という問い合わせが来たとします。
過去にも似た問題が発生していれば、その問い合わせを参考にできそうです。
しかし、過去の記録には、
「レポート画面の表示が遅い」
と書かれているかもしれません。
言葉が完全に一致していなくても、内容が似ている問い合わせを探したいところです。
そこで今回は、Amazon Bedrock Knowledge Baseを使ったRAGの仕組みを組み合わせました。
RAGは、質問に関連する情報を検索し、その内容を生成AIに渡して回答させる仕組みです。
実際に、
「レポート画面が固まり、タイムアウトすることがあります。関連する問い合わせを探してください」
と質問してみました。
すると、
「T-001:レポート画面の表示が遅い」
「T-004:帳票表示が終わらない」
という関連する問い合わせが見つかりました。
さらに、質問の表現を変えても、内容の近い問い合わせを検索できました。
キーワードが完全に一致しなくても、文章の意味が近い情報を探せる。
問い合わせ対応などで役立ちそうな仕組みです。
データカタログだけですべてができるわけではない
ここで重要なのは、SageMaker Catalog自体がデータを分析したり、文章の意味を理解して検索したりするわけではないことです。
今回の検証では、
- データの所在や意味を整理する:SageMaker Catalog
- アクセスログを集計する:SageMaker Data AgentとAthena
- 問い合わせ文書を検索する:Bedrock Knowledge Base
というように、それぞれのサービスを組み合わせています。
また、問い合わせ文書はカタログに登録するだけでは検索できず、Knowledge Baseへの取り込みも必要です。
つまり、データを整理する仕組みと、実際に分析・検索する仕組みを組み合わせることが重要なのです。
生成AIを使う前に、データを使える状態にする
生成AIの技術が進化すると、
「AIがどこまで賢くなったか」
「どんな複雑な質問に答えられるか」
といった部分に注目しがちです。
しかし、今回の検証では、その前段階にあるデータ整理の重要性が見えてきました。
どれだけ優秀なAIがあっても、必要なデータが見つからなければ活用できません。
また、データが見つかっても、各項目の意味が分からなければ、正しく分析することは難しくなります。
だからこそ、
「どんなデータがあるのか」
「それぞれのデータは何を意味するのか」
「何のために利用するのか」
を整理しておくことが重要です。
生成AIを活用するためには、AIモデルだけでなく、AIが利用するデータを整えることも必要なのです。
まとめ
今回は、Amazon SageMaker Catalogを使ってデータカタログを作成し、生成AIによるログ分析や問い合わせ検索につなげてみました。
今回の検証で分かったのは、データは蓄積するだけでは十分ではないということです。
必要なデータを見つけ、その内容を理解し、適切な方法で利用できるようにしておく。
そうした土台があってこそ、生成AIによる分析や検索の価値を引き出しやすくなります。
Acroquestでは、生成AIの新しい機能を試すだけでなく、**「実際の業務でAIを活用するためには、どのような仕組みが必要なのか」**まで考えながら技術検証を行っています。
AIそのものだけでなく、データの管理やシステム構成も含めて、新しい技術を実際の業務につなげていく。
そんな開発に興味のある方は、ぜひ一度お話ししましょう。
記事の詳細、検証に用いた実装コードなど詳しくは当社技術ブログに記載しておりますので、詳細を知りたい場合はこちらをご覧ください。
ぜひ、当社で一緒に働いてみませんか?
チャレンジングな案件が多く、成長の機会が多く得られる環境です
当社では、機械学習/AIや生成AIに加えて、AWSやAzureを活用したITサービス開発事業を推進しています。そこで、最先端技術を駆使しながら、社会を進化させたい情熱とスキルのある機械学習・AIエンジニア、クラウドエンジニアを募集しています!
私たちが取り組む案件は、最先端技術を用いる内容や高難易度の内容が多く、チャレンジングな環境なので、成長の機会が多く得られることをお約束します。


/assets/images/10338/original/b4c1f58c-4c92-447a-a0cc-671371e80f3a.png?1392712942)