こんにちは!株式会社Freedoming人事担当の平区です🌈
前回好評だったクラウドエンジニア兼PM板矢による「AWS超入門」。
今回は、いよいよお待ちかねの【運用編】をお届けします!
☁️ システムは「作ってから」が本番!
さて。そもそも、なぜ今『運用』を学ぶ必要があるのでしょうか?
『作り方のほうが楽しそう!』と思いますよね。
。。。実際作るほうが楽しいです!(笑)
答えはシンプルで、『作る期間より、使う期間のほうが圧倒的に長い』から!
構築に1年かかったシステムが、その後10年以上使われ続けることは珍しくありません。
システムの一生のうち、なんと9割以上は『運用』の時間なんです。
そしてシステムの評価は『上手に作れたか』ではなく、『安定して使い続けられたか』で決まります。
つまるところ運用とは、システムの価値を守り続ける仕事なのです。
今日はこの、簡単で奥深い『運用の世界』をご案内します。
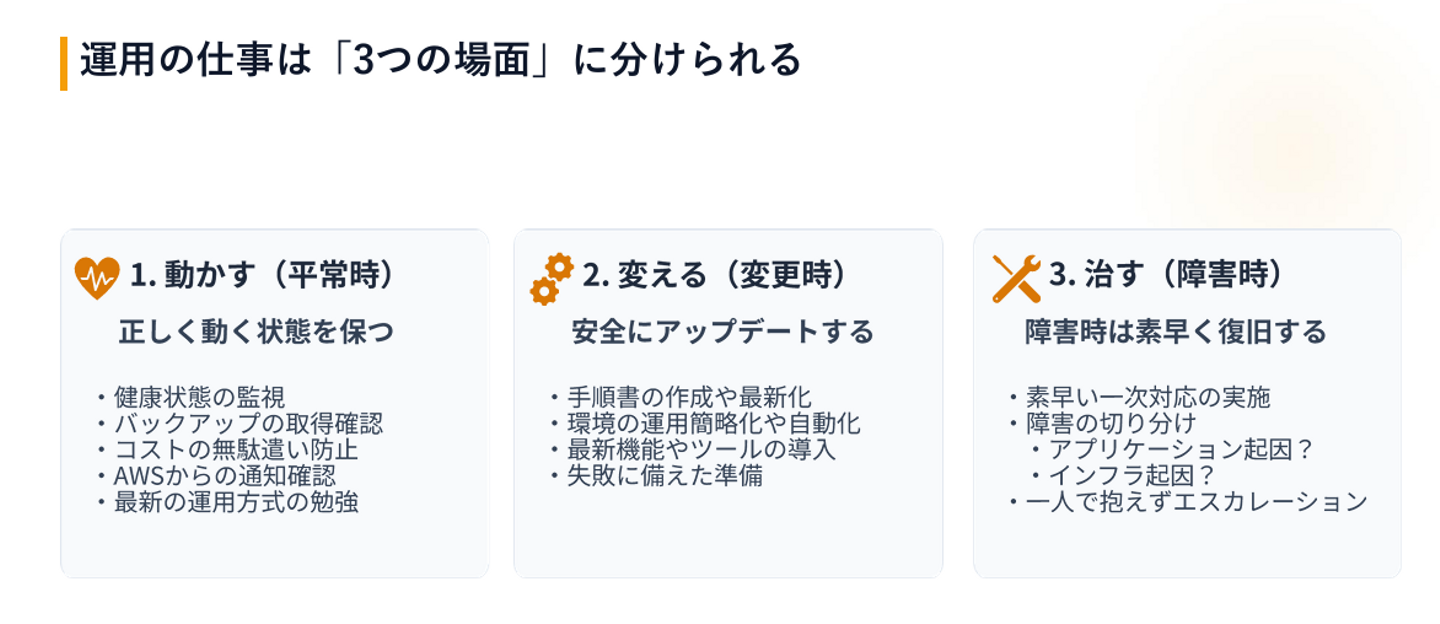
前回の『4分類』と同じように、今回は『運用の全体像』を用意しました。
運用の仕事は大きく【3つの場面】に分けられます。
① 動かす(平常時)
監視、バックアップ、コスト管理で、動いている状態を保つ仕事。 地味に見えて一番大切な、そして運用の大部分を占める時間です。
② 変える(変更時)
古い機能を見つけ、新しい機能への変更を考え、手順書を整え、安全にアップデートをする。 運用の中でも最もドラスティックな時間になります。
③ 治す(障害時)
障害が発生したら素早く復旧し、『アプリ起因か、インフラ起因か』を切り分ける仕事です。(※全エンジニアに聞いた『運用作業の中で最も来てほしくない瞬間ランキングナンバー1』だと私は考えています。笑)
今日はこの順に見ていきましょう!
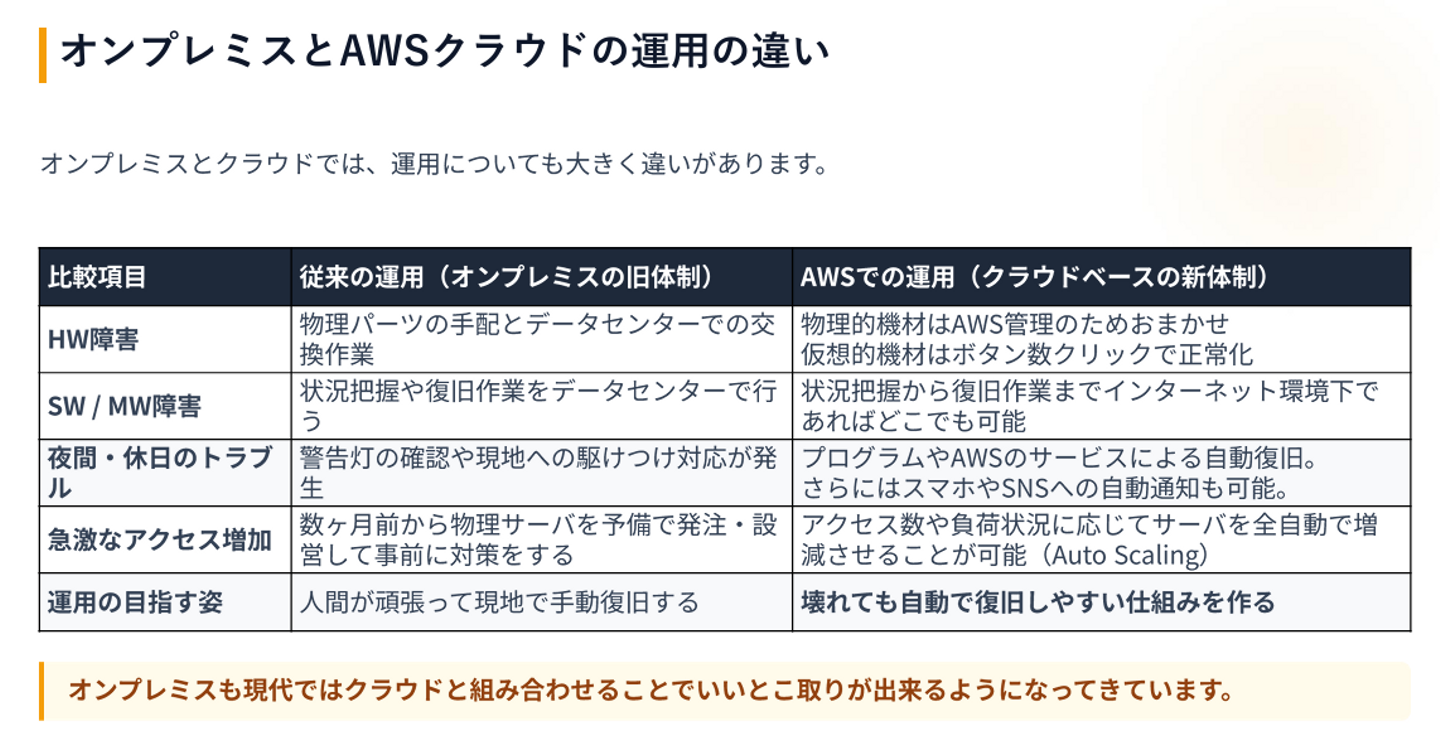
さて、各項目の詳細に入る前に、ここで少し温故知新の時間といきましょう。
オンプレとクラウドで運用がどう変わったのかを、この表で押さえます。
例えばハードウェア障害。 オンプレは物理パーツを手配して現地で交換していました。対してクラウドは物理層をAWSにおまかせして、仮想サーバは数クリックで入れ替えです。
なぜか夜間に発生することが多かった緊急トラブルの対応も、大きく様変わりしました。 一昔前は、電話一本でエンジニアが現地へ駆けつけていました。。。
それが『スマホへ自動通知、作り込めば自動復旧まで済む』世界に変わったのです。
ここで一番お伝えしたいのは最後の行、『運用の目指す姿』です。
クラウド運用の目指す姿は、『人間が頑張って現地で手動復旧する』ではなく『壊れても自動で復旧しやすい仕組みを作る』。今日の話はすべて、この一行につながります!
なお、これはオンプレが古い・ダメという話ではありません。 前回お話しした通り優劣はなく、現代は組み合わせて『いいとこ取り』する構成も増えています。
では話を本題に戻し、運用の仕事、まずは平常時の『動かす』仕事からお話をしていきましょう!
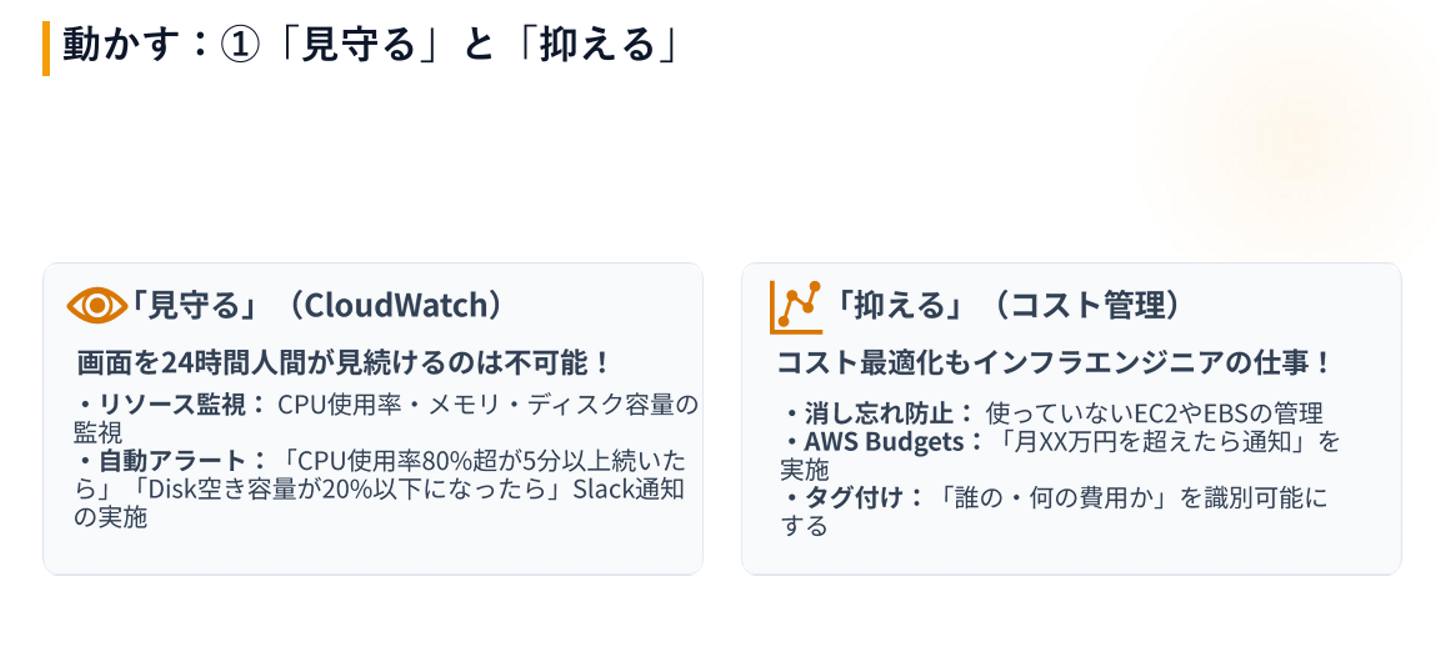
『動かす』仕事の代表として2つ挙げさせていただきました。
👀 1つ目は「見守る」
つまり、監視です。 夜間監視部隊を作ったりしない限り、24時間365日常に人間が見続けるのは不可能です。 ここは前回ご紹介したCloudWatchに見張らせましょう。 『CPU使用率80%以上が5分続いたら』『ディスクの空きが20%以下になったら』Slackへ通知、といったアラートを仕込んでおくわけですね。
🚨 【実務の注意点】
『アラートが鳴っても誰も動かない』状態は、監視が無いのと同じです。
気になる所は全部入れておこう!とアラート増やしすぎた結果、全部無視された…というのは現場の定番の笑い話です。
『鳴ったら必ず誰かが動く』『クリティカルな部分に絞る』という実装が大事です。
💰 2つ目は「抑える」
コスト管理です。かつて『イタヤ』という人が自分のアカウントの管理を怠ったせいで発生した『40万円請求事件』。笑
これをさらに大規模にしたものが、会社規模で発生することもあります。(実際コスト管理が甘かったせいで数千万円をドブに捨てた…みたいな会社さんもあります)
こういった悲劇を防ぐ仕事も、立派な運用の営みです!
- 使っていないリソースの棚卸し
- 月額予算の超過通知を行う『AWS Budgets』
- 誰の・何の費用かを識別する『タグ付け』
この3点セットは効果大です!
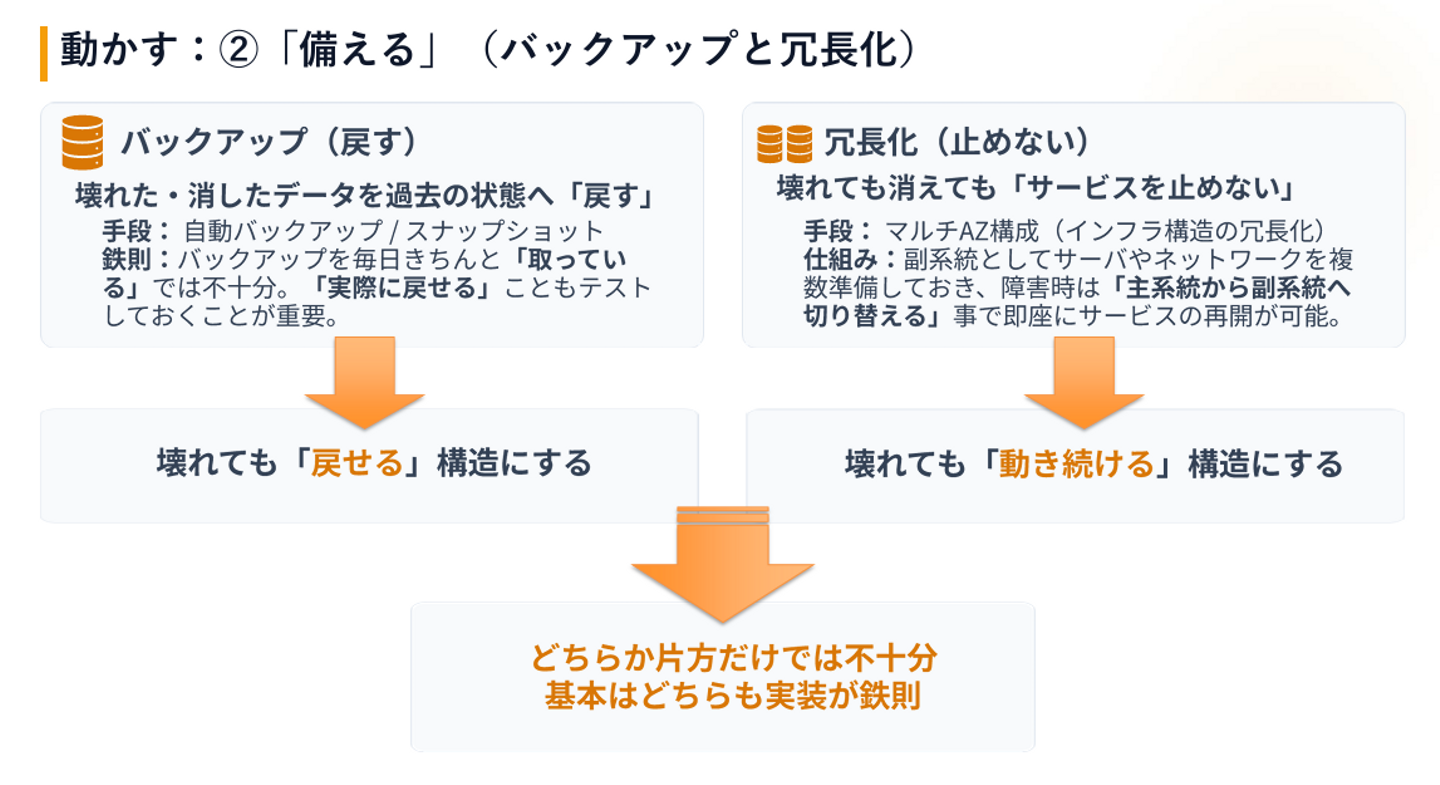
平常時のもう1つの仕事が、障害への『備え』です。
勘違いしやすく、けれど似て非なる概念が2つ出てきますが、わかりやすく整理しながらお話しますね。
💾 バックアップ(戻す)
→ 厳密には、壊れたデータを過去の状態へ『戻す』機能です。 みなさんが使っているMacBookの『Time Machine』もこれですね。ジョブズのセンスを感じます(笑)。 ここでの鉄則は『取っているか』ではなく『実際に戻せるか』です。復元を試したことのないバックアップは、開くかわからない非常口を全面的に信頼しているのと同じ。必ず事前にテストしておきましょう!
🛞 冗長化(止めない)
→ 聞いたことがない方もいるかもしれませんが、こちらは壊れても『サービスを止めない(動かし続ける)』ためのものです。例えるなら車の『スペアタイヤ』ですね。 普段動いている主系統とそっくり同じ副系統を用意しておき、障害時は主系統から副系統へ切り替えることで即座にサービスを再開させます。AWSでは『マルチAZ構成』などが代表例です。
そして、スライド下の結論はぜひ覚えて帰ってほしいです。
バックアップは『戻せる』構造。冗長化は『動き続ける』構造。 司る役割が全く違うため、片方だけでは不十分です。『基本はどちらも実装が鉄則』ということですね。
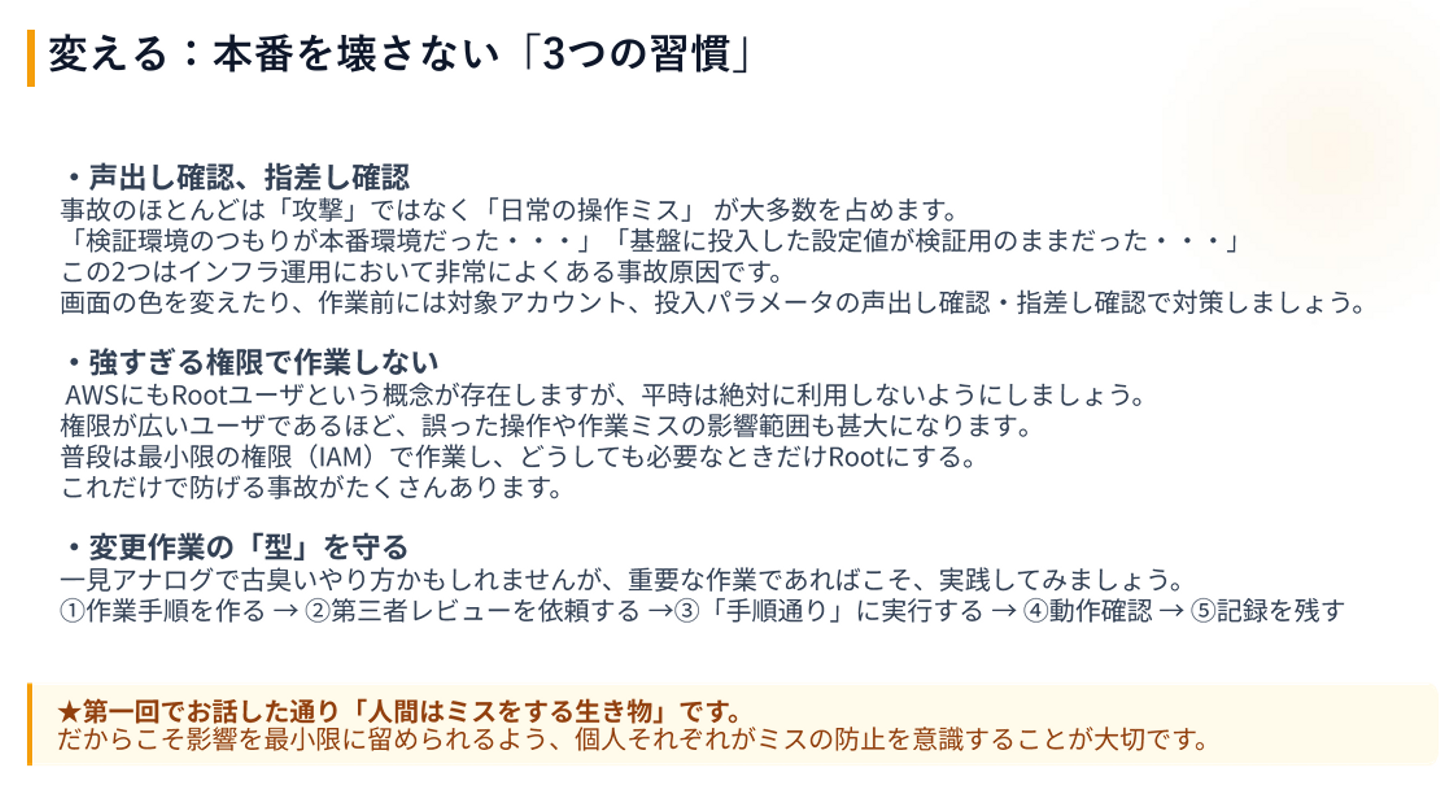
次は『変える』仕事です。
ここで元も子もない事を言ってしまいますが、実はインフラ運用で発生する事故の大多数は『攻撃』ではなく『日常の操作ミス』で起きています。 『検証環境のつもりが本番環境だった』『基盤に投入した設定値が検証用のままだった』。この2つが定番の事故原因です。
こういうミスの対策は、原始的であればあるほど効きます。
👉 1. 声出し確認、指差し確認
環境ごとに画面の色を変えたり、作業前に対象アカウントやパラメータを声出し・指差し確認しましょう。 かくいう私は、とある鉄道会社さんに倣い、指差し確認をインフラを始めた頃からずっと続けています。ありがたいことに、今まで大目玉を食らうような致命的なミスは一度もやったことがありません。これは本当に効くので、ぜひ皆さんも『指差し確認ヨシ!』やってみてください。
🛡️ 2. 強すぎる権限で作業しない
一切の制約・制限のないRootユーザーは、平時は絶対に使わないようにしましょう。 アクセス制限は、システムと『あなた自身』を守るガードレールです。普段は作業用に最小限の権限(IAM)に絞って利用するようにしましょう。権限が広いほど、作業ミスの被害も甚大になります。
📋 3. 変更作業の「型」を守る
手順書をつくり、第三者レビューを仰ぎ、記載通りに実行し、動作確認をして記録を残す。 一見アナログで古臭いやり方かもしれませんが、重要な作業であればこそ大切になってきます。インフラでミスをすると、最悪の場合サービスが完全に止まることもあります。慎重すぎる程度がちょうどよい、ということを是非覚えておいてください。
そして下の帯の通り、『人間はミスをする生き物』です。
大小含めるとミスをゼロにすることは不可能です。だからこそ、致命的なミスだけは起こさないよう影響を最小限に留める、そういった習慣をぜひ作りましょう!
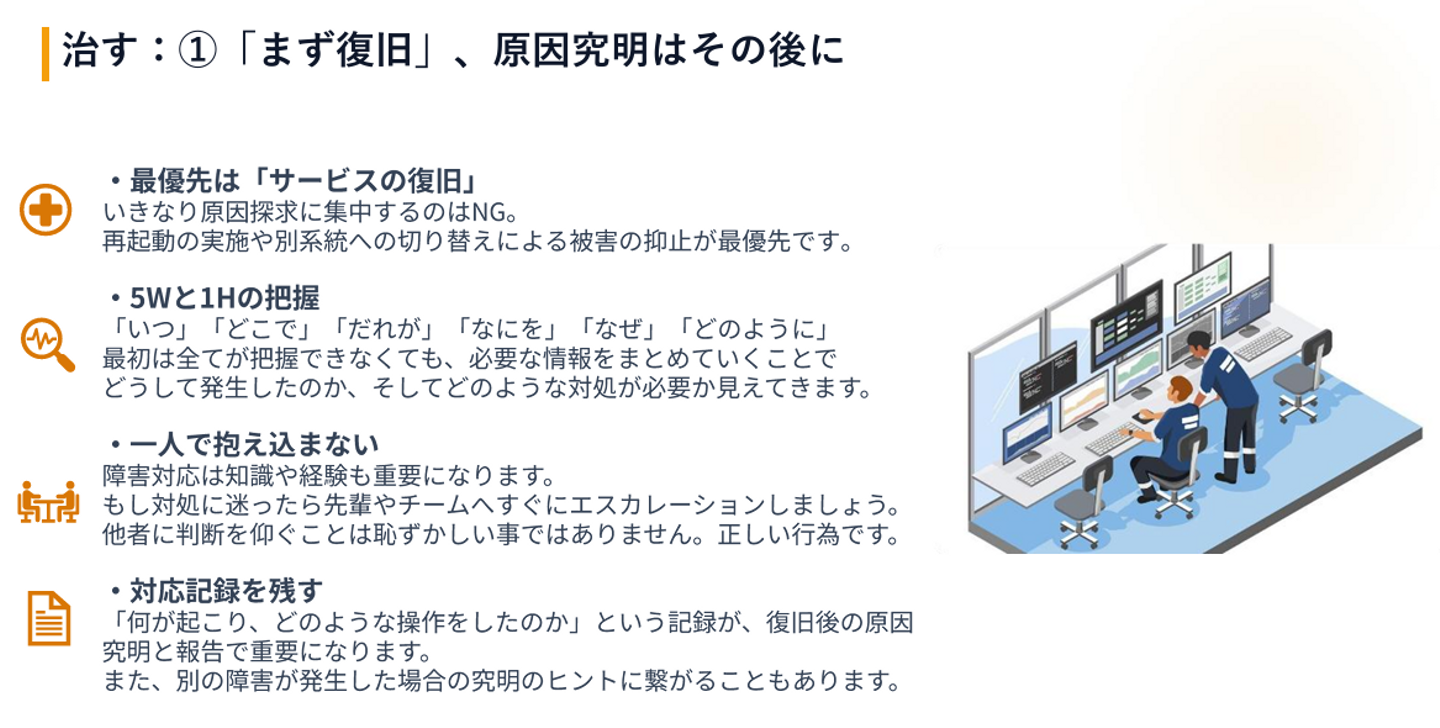
では最後の3つ目の場面、『治す』仕事です。
障害が発生した!どうしよう!
ここでやりがちなのが『原因を突き止めてから直そう』とすることです。
ですがちょっと待ってください?
あなたが原因を細かく調べている間もシステム障害は発生していて、サービスは停止していて、ユーザは困っています。これでは、いけませんね。
🚑 1. 最優先は「サービスの復旧」
いきなり原因探求に集中するのはNGです。再起動の実施や別系統への切り替えを行い、まず被害の拡大を止めるのが最優先です。原因究明はその後です。
📝 2. 5W1Hの把握
そうはいっても、障害がどこでどうやって発生したかが一瞬でわかるなんてことは稀です。そんなときは『いつ・どこで・だれが・なにを・なぜ・どのように』を分かる範囲から埋めていきましょう。少しずつ情報をまとめることで、対処すべきことが見えてきます。
🗣️ 3. 一人で抱え込まない
迷ったらすぐに上長や有識者(先輩やチーム)へエスカレーションしましょう。冒頭を繰り返しますが、あなたが30分悩むことで、ユーザの困る時間が30分伸びます。他者に判断を仰ぐことは恥ずかしい事ではありません。間違いなく、正しい行為です。
✍️ 4. 対応記録を残す
『何が起こり、どのような操作をしたのか(結果どうなったのか)』という記録が、復旧後の原因究明と報告の生命線になります。RedMineやBacklog、Jiraなどに残すようにするとなお良いでしょう!
『治す』仕事はスピード勝負ということが伝わったかと思います。
つまり闇雲に原因を探し、暗中模索をするのはよくありません。
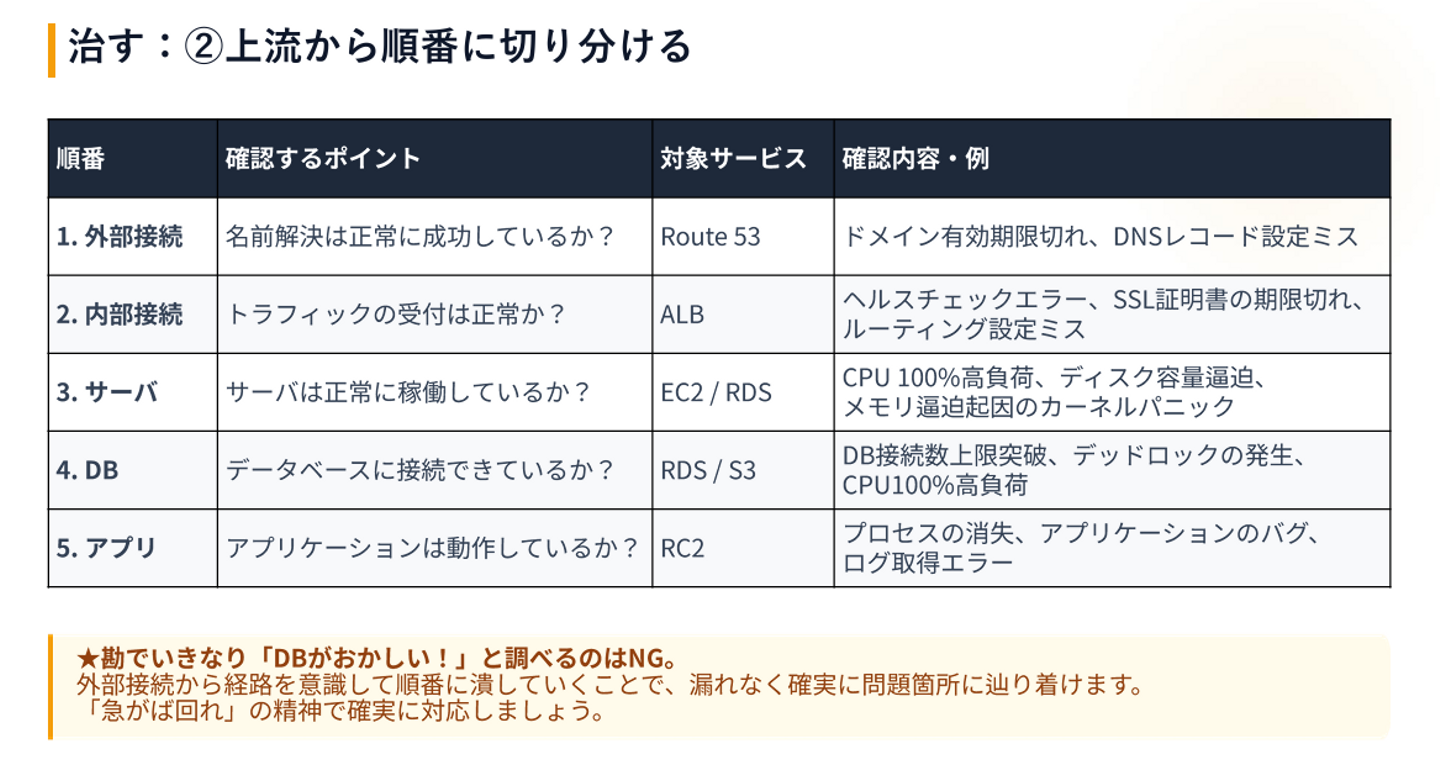
ここで障害箇所の探す際のアドバイスを。合言葉は『上流から順番に』。
つまり、ユーザのアクセスが外部のインターネットから内部のDBやS3などに向けて流れていく順番ですね。
🌐 1. 外部接続(Route 53など)
まずは名前解決が正常に成功しているかを見ます。『ドメインの有効期限が切れていて名前解決ができなくなっていた…』という事案は、大企業でもやらかす事があります。
🚪 2. 内部接続(ALBなど)
次にトラフィックの受付を見てみましょう。具体的にはヘルスチェックや証明書を見ます。『SSL証明書が失効していた』『ルーティング先が想定からズレていた』みたいなことは意外とあるあるです。
🖥️ 3. サーバ(EC2 / RDSなど)
いよいよ本丸。サーバの正常稼働状態を見ます。CPUが100%に張り付いていないか、メモリの空き容量が逼迫したことでカーネルパニックが起こっていないかなどを疑います。
🗄️ 4. DB(RDS / S3など)
ここも問題なさそうなら、データベースへの接続を疑います。RDSで障害が発生していることでクエリが正常に処理できない、S3に置いてあるファイルが参照できずエラーが出た…などが代表例でしょうか。
💻 5. アプリ
インフラは正常に動いていそうだ、となったら5つ目の『アプリ起因』を疑います。開発チームにヒアリングをしてみたり、サーバ内のアプリケーションログを確認したりします。
こうやって、障害が発生した場合は上流から順番に切り分けて対応を行います。 今日の一番最初にお話した治す場面の『障害の切り分け』が、まさにこの流れです。
🚨 【絶対にやってはいけないこと】
勘でいきなり『DBがおかしいだろ、うん。きっと!』と一点賭けの全ベットをすること。 だいたい読みは外れ、無為に時間が過ぎていきます。 『急がば回れ』の精神で外部から経路を意識して順番に潰せば、漏れなく確実に原因に辿り着けます!
さて、ここまで運用の基本となる『動かす・変える・治す』の3つの場面についてお話ししてきました。
インフラ運用が、システムを守り続けるための奥深~い仕事であることが少しでも伝わっていれば嬉しいです!
では、『理論はわかったけど、実際のアラート画面を見たらどう動けばいいの?』と気になりますよね。
そこで次回【後編】では、
『障害が発生しました!Slackにこんなアラートが届いています。あなたならどう動きますか?』
という、超実践的なトラブルシューティングのシナリオをご紹介します🔥
さらに、インフラエンジニアの腕の見せ所である『OSI参照モデル』を用いた監視の考え方や、AWSだからこそできる『運用自動化』の技術も公開です!
次回の更新もぜひ楽しみにお待ちください✨
本日もここまでお読みいただき、ありがとうございました!
また次の記事でお会いしましょう(^O^)/

/assets/images/24080777/original/686d1498-c291-48a6-a612-a6a110062297?1782263834)