ChatGPTをはじめとする生成AIは、さまざまな質問に答えてくれます。
しかし、会社の業務で使おうとすると、
「社内独自のルールを知らない」
「自社の商品について答えられない」
「社内用語の意味を理解してくれない」
といった問題が出てきます。
そこで重要になるのが、
「生成AIに、自分たちの知識をどう渡すか」
という技術です。
RAG、GraphRAG、Knowledge Graph、セマンティックレイヤー、OKF……。
生成AIの世界では、ここ数年でさまざまな技術が登場しています。
なぜ、こんなに新しい仕組みが次々と出てくるのでしょうか?
今回は、生成AIへの「知識の渡し方」がどう変わってきたのかを整理しながら、GraphRAGとOKF(Open Knowledge Format)を実際に動かして比較してみました。
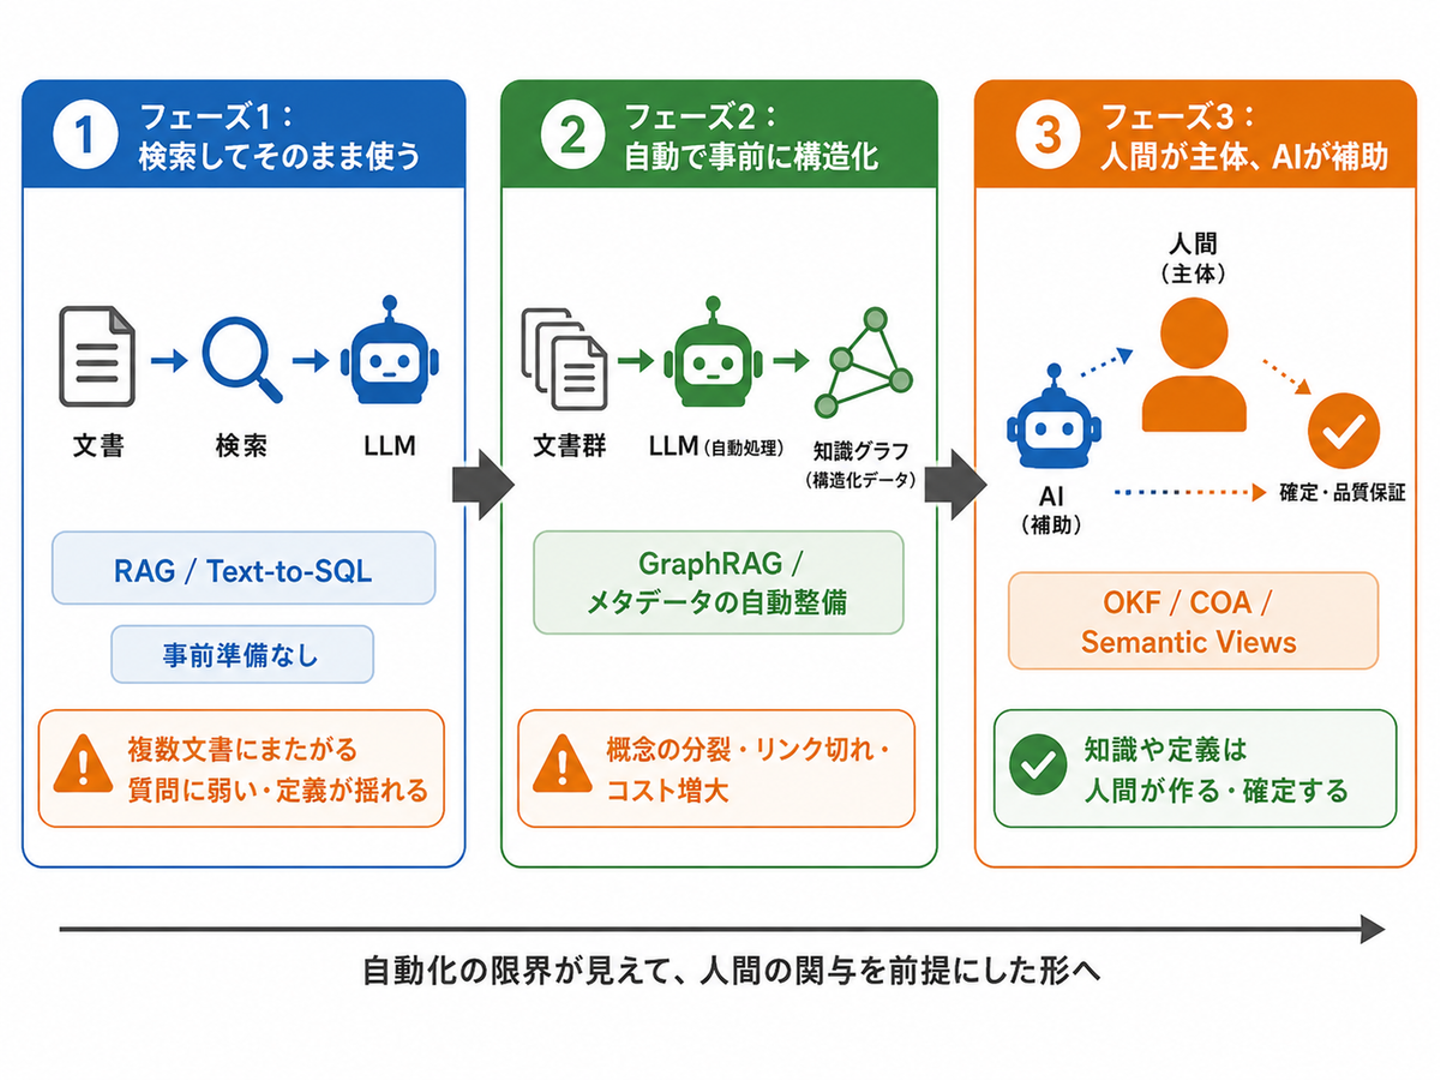
第1段階:必要な情報を「検索して渡す」
生成AIに社内情報などを使わせる方法として広く使われるようになったのが「RAG」です。
考え方はシンプルです。
ユーザーが質問する
↓
関連する文書を検索する
↓
見つけた情報をAIに渡す
↓
AIがその情報をもとに回答する
例えば、「商品の返品期限を教えて」という質問に対して、社内マニュアルから返品について書かれた箇所を検索し、その文章をAIへ渡します。
AI自体が返品ルールを覚えていなくても、必要な情報をその場で渡せば回答できます。
現在でも、多くの質問ではこの方法が十分有効です。
しかし、実際の業務へ適用していくと、検索するだけでは難しいケースも出てきます。
例えば、
「この社内用語は何を意味する?」
「Aさんが所属する部署が担当している製品は?」
「売上と言ったとき、どのデータをどう集計する?」
といった質問です。
単純に似た文章を検索するだけでは、必要な情報が揃わないことがあります。
第2段階:情報同士の「関係」までAIに整理させる
そこで登場したアプローチの一つが「GraphRAG」です。
通常のRAGが文書を検索するのに対し、GraphRAGでは事前に文書をAIに読み込ませ、
「何と何が関係しているのか」
まで整理しておきます。
例えば、
「Aさんは営業部に所属している」
「営業部は商品Xを担当している」
という2つの情報があれば、
Aさん→営業部→商品X
という関係をたどれます。
このように複数の情報を組み合わせないと答えられない質問では、知識をグラフとして持つことが有効です。
では、
「全部AIに読ませて、自動で知識を整理してもらえばいいのでは?」
と思うかもしれません。
実際、そうした方向でも技術は発展してきました。
しかし、ここにも難しさがあります。
AIに全部整理させると、同じものが「別物」になる?
例えば文書の中に、
「PostgreSQL」
「Postgres」
という表記があったとします。
人間なら、同じデータベースを指しているとすぐ分かります。
しかし、AIが大量の文書から自動で知識グラフを作ると、それぞれを別の概念として登録してしまうことがあります。
同じものなのに、複数のノードに分かれてしまうわけです。
さらに、大量の文書をAIに読み込ませて知識構造を作るため、トークン消費も増えていきます。
そこで最近は、少し違った考え方が登場しています。
第3段階:「全部AIに任せる」から、人とAIで知識を育てる
2026年にGoogle Cloudが発表したのが「OKF(Open Knowledge Format)」です。
OKFでは、知識をMarkdownベースのWikiのような形で管理します。
例えば、
PostgreSQL.mdSQL.mdMVCC.md
といったように、
「1つの概念に1つのページ」
を対応させます。
ページ同士はMarkdownのリンクでつなげます。
ここで重要なのは、
AIに「何という概念が存在するのか」までゼロから考えさせる必要がない
ということです。
例えば、既存システムに「PostgreSQL」という概念が存在することが分かっているなら、それを土台として使います。
そのうえで、
「この概念にはどんな説明を書くか」
「どの概念と関連しているか」
といった部分をAIに補助してもらいます。
似た考え方として、AWSからも「Context Ontology Accelerator」が登場しています。
こちらもAIがすべてを決めるのではなく、AIが作った知識構造の案を専門家がレビュー・承認して利用する仕組みです。
つまり、知識の渡し方が、
検索して情報を渡すから、AIに知識構造まで作らせる
そして、
人間や既存システムが土台を作り、AIに整理を補助してもらう
という方向にも広がってきています。
本当に違いは出る? GraphRAGとOKFを比較してみた
そこで今回は、この違いを実際に確かめてみました。
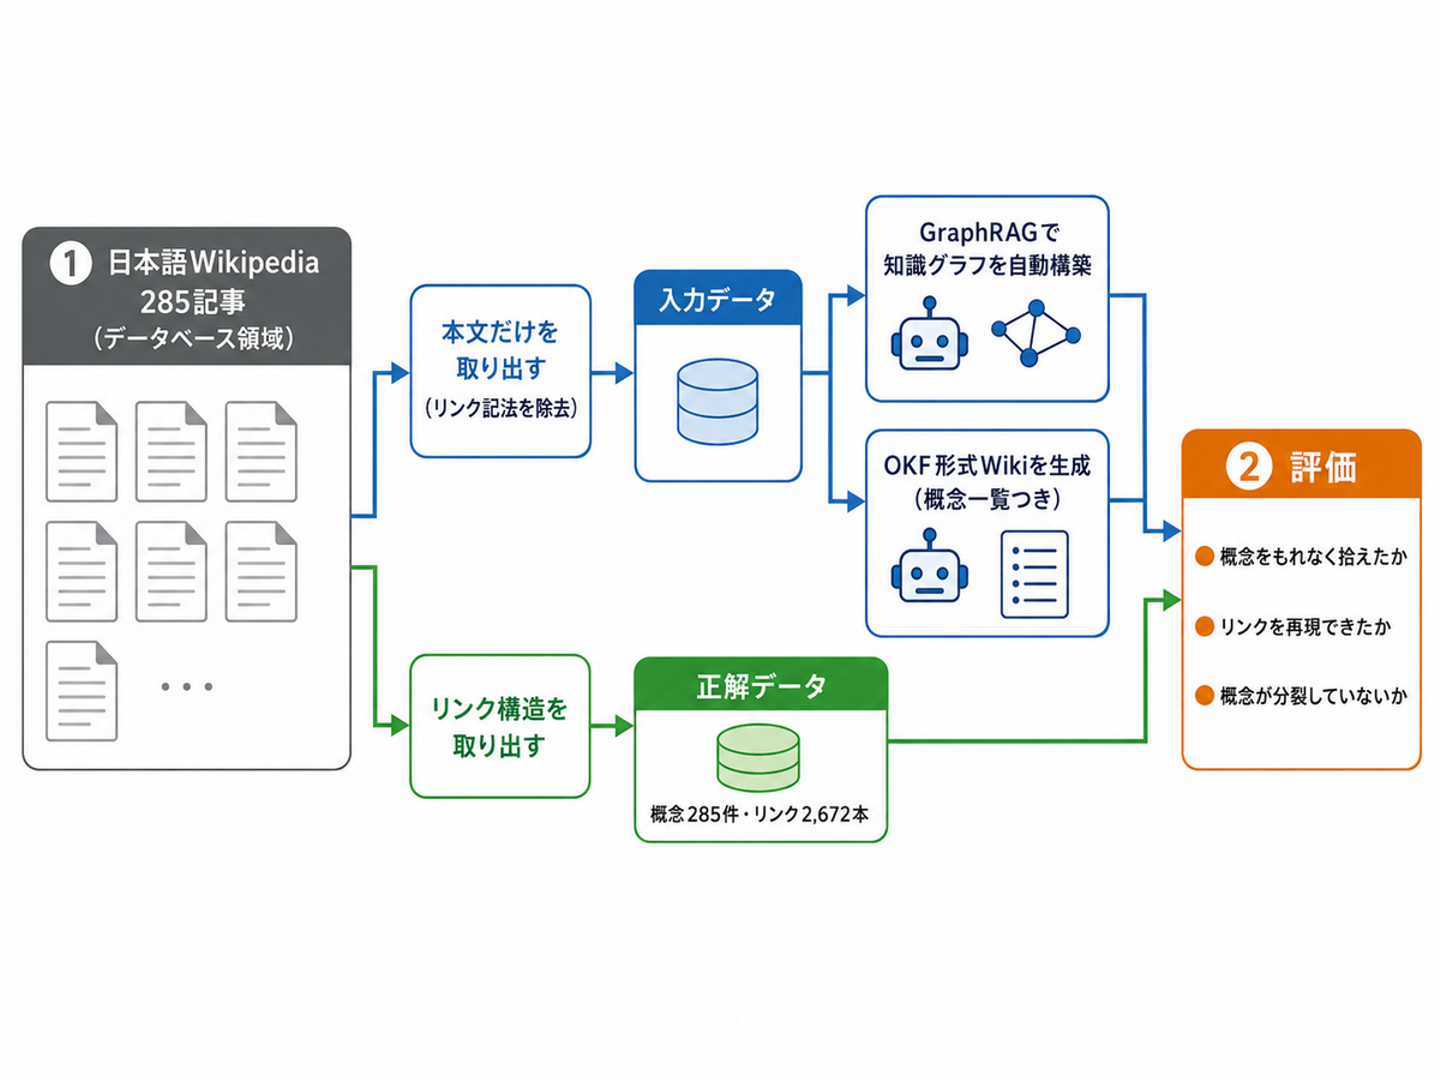
検証には、日本語Wikipediaのデータベース関連285記事、約74万字を使用しました。
正解となる概念は285個。
記事同士のリンク2,672本を、「正しい関係」として扱います。
これを、
GraphRAGと、あらかじめ285個の概念を与えたOKF形式のWiki
でそれぞれ構築し、同じLLMを使って比較しました。
結果は次のようになりました。
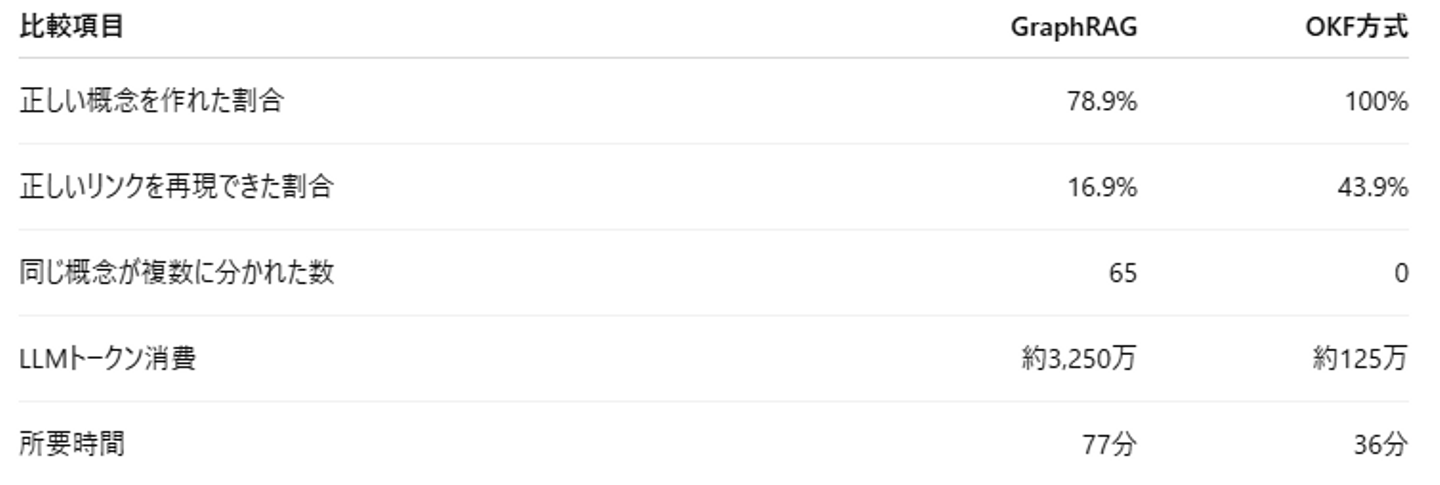
特に大きかったのが、トークン消費です。
今回の条件では、OKF方式はGraphRAGの約1/26でした。
また、GraphRAGでは同じ概念が別々のノードとして作られるケースが65件発生しましたが、OKF方式では0件でした。
「OKFの方がAIとして優秀」という話ではない
ただし、この結果だけを見て、
「OKFの方がGraphRAGより優れている」
と考えるのは適切ではありません。
今回のOKF方式には、最初から285個の概念一覧を与えています。
つまり、
「何という概念が存在するのか」
をAIに考えさせていません。
その判断を人間や既存システム側で済ませているからこそ、同じ概念が複数に分かれる問題を防ぎ、AIが処理する量も減らせています。
一方、GraphRAGには、文章から「どんな概念が存在するか」を見つけるところから任せています。
そもそもAIに任せている仕事の範囲が違うのです。
それでも、人間の確認は必要
では、土台だけ用意すれば、あとは全部AIに任せられるのでしょうか?
今回の結果を見ると、そうとも言えません。
OKF方式でも、正しいリンクを再現できた割合は**43.9%**でした。
概念をあらかじめ固定すれば、
「PostgreSQLとPostgresを別物として登録してしまう」
といった問題は防げます。
しかし、
「PostgreSQLと、この技術には関係がある」
という関係性の判断まで、常に正しくできるわけではありません。
そこにはまだ、人間によるレビューや修正が必要です。
AIが進化すると、人間はいらなくなる?
生成AIの進化というと、
「これまで人間がやっていたことを、どこまでAIに任せられるか」
という話になりがちです。
しかし今回調べてみると、少し違った方向も見えてきました。
何もないところからAIにすべて考えさせるのではなく、
人間や既存システムが正しい土台を用意し、その上でAIに得意な仕事を任せる。
その方が、精度だけでなくコスト面でも有利になるケースがあります。
これは、AIの性能だけの問題ではありません。
「何をAIに考えさせて、何をシステムや人間側で決めておくのか」
を設計することが重要になってきています。
まとめ
生成AIに自分たちの知識を使わせる方法は、少しずつ広がっています。
最初は、
必要な情報を検索してAIに渡す「RAG」
が中心でした。
そこから、
情報同士の関係までAIに整理させる「GraphRAG」
のような方法が登場しました。
そして現在は、
人間や既存システムが知識の土台を作り、AIに整理を補助させる
というアプローチも出てきています。
大切なのは、新しい技術が出たからといって、すべて置き換わるわけではないことです。
普通のRAGで十分なケースもあります。
複数の情報をたどる必要があるなら、GraphRAGが有効なケースもあります。
そして、組織として正しい知識を長く管理していくなら、人間とAIが一緒に知識を育てる方法も選択肢になります。
「最新技術だから使う」のではなく、何を解決したいのかによって技術を選ぶ。
Acroquestでは、新しく登場した生成AI技術を試すだけでなく、
「なぜこの技術が登場したのか」
「従来の方法と何が違うのか」
「実際にどんな場面で使えるのか」
まで自分たちで検証しています。
生成AIの新しい技術を追いかけながら、それを実際のシステムでどう使うかまで考えてみたい方は、ぜひ一度お話ししましょう。
記事の詳細、検証に用いた実装コードなど詳しくは当社技術ブログに記載しておりますので、詳細を知りたい場合はこちらをご覧ください。
ぜひ、当社で一緒に働いてみませんか?
チャレンジングな案件が多く、成長の機会が多く得られる環境です
当社では、機械学習/AIや生成AIに加えて、AWSやAzureを活用したITサービス開発事業を推進しています。そこで、最先端技術を駆使しながら、社会を進化させたい情熱とスキルのある機械学習・AIエンジニア、クラウドエンジニアを募集しています!
私たちが取り組む案件は、最先端技術を用いる内容や高難易度の内容が多く、チャレンジングな環境なので、成長の機会が多く得られることをお約束します。


/assets/images/10338/original/b4c1f58c-4c92-447a-a0cc-671371e80f3a.png?1392712942)