概要
ClaudeCodeが日々の業務に馴染んできてくれたので、仲良くなる前に知っておきたかったことをまとめてみます。
背景
世に出回っている情報を見ていると、コーディングエージェントを高度に活用し、AI向けに最適化された開発フローがあふれているように感じます。
輝かしい成果が流れてくる反面、どのようにステップアップしていけば使いこなせるのか、イメージを深められるような知見には出会えていませんでした。
幸いなことにClaudeCodeに向き合う時間・タイミングが揃って少しだけ手に馴染んだように感じてきたので、どうすれば開発にコーディングエージェントを取り入れられるのか、考えたことを整理してみます。
記事の構成
この記事では、業務で関わることが多い「アプリケーションへの追加機能開発」の流れにどうやってClaudeCodeを取り入れるか見ていきます。
具体的には、設計から始まり、実装・テストまで完遂させるには何を考え、どう使えば良いのか掘り下げていきます。
ざっくり要約
- grillingスキルで壁打ちしてつくった設計書・スキルに思考を反映
- 思考が反映された文書からコーディングエージェントに動いてもらうことで、自分は思考と理解に専念し、手を動かすのはClaudeCodeという役割分担ができる
- 作業をClaudeCodeに任せる分、理解を確実なものにすることに時間を充てることで、開発スピードを上げつつ品質も担保することを目指す
最初の一歩
ここでは、実際に機能開発にClaudeCodeを導入する前の準備段階でやってよかったことを書きます。
書籍を読む
コーディングエージェントがなにもわからない状態を脱却するため、まずは実践Claude Code入門を読むところから始めました。
半年ほど前に出た書籍ではありますが、コーディングエージェントの仕組み・構成要素を幅広く解説してくれているので、ClaudeCodeに入門しようと思ったらまず初めに手に取りたいです。
grillingスキルとの出会い
grillingスキルがいいという評判をよく聞いていたので、とりあえず入れてみました。
お試しで使ってみたところ、かなり良さそうだったので、機能開発で実際に使ってみようと思いました。
どんなところが良かったのか、簡単なサンプルから見ておきます。
以下のようにタスク管理ツールのチケットに書くようなテキストを入力に与えると、たくさんの質問を経ることで自分の思考をコーディングエージェントのメモリ(コンテキスト)に載せることができます。
# claudeコマンドを呼び出したあとのセッションにて「/スキル名」でコマンドを呼び出す。コマンド名のあとにスペースを空けて入力を渡している

# 入力内容は個人ブログアプリのバグ修正のような軽めのタスク

/grilling # ゴール


記事中に`{{ some_variable }}`のようなDTLの記法が書かれていてもDjangoのテンプレートとして解釈せず、そのまま表示できるようにしたい。


## 背景


Djangoをテーマにした記事を書くとき、DTLの記法を記述するとDjangoのテンプレートエンジンに解釈され、存在しない変数を

参照したとみなされ、パースエラーとなった。


includeタグで読み込んだ記事データではDjangoに解釈させないようなテンプレートタグが無いかも探したが、どうやら無さそう。

よって、記事データをファイルに保存するとき、先頭と末尾に`verbatim`テンプレートタグを追加することでDTLにパースさせないようにしたい。
grillingスキルを呼び出すと、以下のように対話形式で質問を投げかけてくれます。
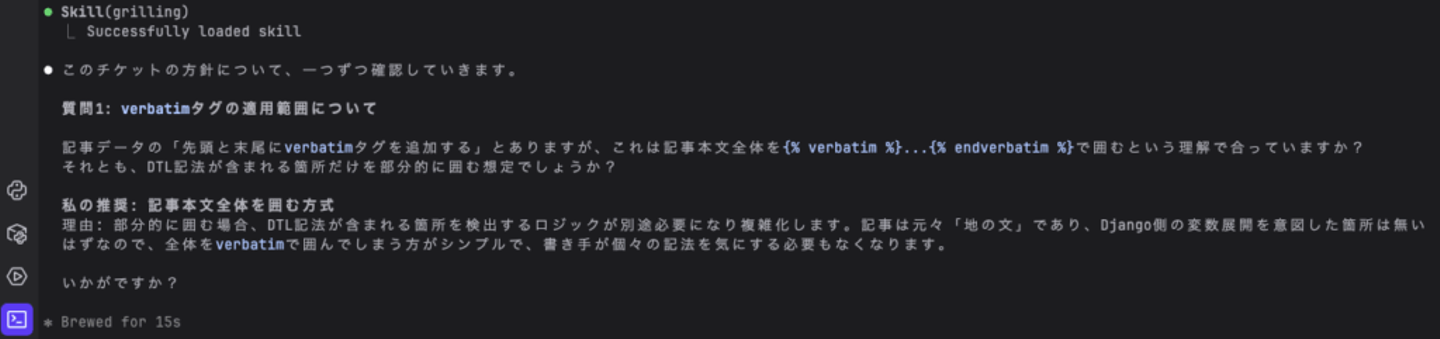
大量の質問に答えて方針を擦り合わせていくと、人間とClaudeCodeの間で思考を共有することができます。
共有された思考を文書化してもらえば設計書になりますし、そのまま実装してもらえば自分が思考した通りの動きで作業をしてくれるようになります。
自分の思考を入力にコーディングエージェントに動いてもらう、というAI開発フローの大まかな流れが掴めたので、実際の機能開発へ導入する土台が整いました。
補足-ClaudeCodeに楽しい実装を任せることについて
ClaudeCodeに開発作業を任せるとなると、楽しい実装作業の時間がなくなってしまうのではないか、という懸念がありました。
ですが、後から振り返ってみるとClaudeCodeを取り入れた機能開発は別の楽しさをもたらしてくれました。
grillingスキルでたくさんの質問を投げかけてくれることで、考える時間・理解するための時間が増えました。
情報を集めて整理し、理解に至るという行為が好きなので、ClaudeCodeに実装を任せるようになっても新しい楽しさを機能開発に見出せるようになりました。
開発の流れが変わったとしても、自分が苦なく楽しんで取り組める領域を見出していきたいです。
設計からテストの流れ
準備段階で情報を集めたり実験してみることで、ClaudeCodeの理解が少しだけ深まりました。
ここからは、ClaudeCodeを機能開発に取り入れた場合、設計・実装・テストして機能を完成させるまでの流れがどのように変わるのかざっくり見ていきます。
なぜその工程をそのように進めるのか、開発フローを決めた理由も添えることで、ここからさらに発展させるときの土台とします。
題材
本格的な機能開発のサンプルがなかったので、簡単なブログアプリケーションを題材にします。
今回は追加機能として記事の検索機能を追加する想定でやってみます。
あくまで流れを知ることが目的なので、何をやっているかざっくり見る程度に覗いてみてください。
設計
まずはgrillingスキルを使い、ひたすら設計方針を詰めていきます。
このとき、入力にはタスク管理ツールのチケットに書くような「背景(なぜやるか)・ゴール(何を目指すか)・補足メモ(課題に感じているところなどあれば)」をまとめたテキストを与えます。
あとはひたすら質問に答え続ける持久戦です。やりとりが終わったら自分で振り返ったりメンバーの設計をレビューできるよう、設計書にまとめるようにしています。
以下に設計書のサンプルを載せます。なぜやるか・どうやるか・どう検証するかをざっくりまとめています。
※ それなりにボリュームがあるので、見出しで何が書いてあるかざっくり流し見する程度で大丈夫です。
# 記事検索機能


## 背景


ブログの記事数が増えてきており、読者が目的の記事にたどり着きにくくなってきている。現状はカテゴリによる絞り込みのみで、キーワードから記事を探す手段がない。


高度な検索(あいまい検索・全文検索エンジンの導入等)までは求めておらず、タイトルまたは本文にキーワードが含まれているかどうかの単純な一致で十分とする。


---


## 機能概要


全画面共通のヘッダーに検索ボックスを追加し、キーワードを入力して送信すると検索結果画面へ遷移する。検索結果画面では、タイトルまたは本文にキーワードを含む記事が一覧画面と同様のカード形式(タイトル・カテゴリ・投稿日/更新日・要約)で表示される。

検索語を入力せず送信した場合は、絞り込みなしで全記事が表示される(一覧画面と同じ挙動)。該当記事が0件の場合は、カテゴリ絞り込みで対象が無い場合と同様、メッセージなしで空の結果を表示する。


なお、検索結果画面を表示している間も含め、ヘッダーの検索ボックスは常に空欄で表示され、直前の検索語は保持しない。


---


## タスクリスト


### 1. Articleモデルへのcontentフィールド追加(models/article.py・migrations)


- `Article` モデルに `content` フィールド(`models.TextField(blank=True, default='')`)を追加

- マイグレーションファイルを追加


**設計方針:** 記事本文は現状DBに保存されておらず、GitHubから取得したMarkdownをHTMLへ変換したうえでテンプレートディレクトリ配下へファイル書き出しされるのみだった(該当ディレクトリは`.gitignore`対象で本番サーバ上にのみ実体を持つ)。本文検索をシンプルなDBクエリ(`icontains`によるOR検索)で完結させるため、GitHubから取得した生のMarkdownテキストをそのまま`content`へ保存する方針とした。HTMLタグ除去やMarkdown記法の除去といった前処理は行わない(高度な検索は不要なため)。


### 2. 記事メタデータ書き込みの冪等化(background/article_model_writer.py)


- `ArticleImage` に `content` フィールドを追加

- `ArticleModelConverter.convert` が `content` を受け取り、`Article.content` へ設定するよう変更

- `ArticleModelWriter.write` を、`path` に一致する既存の `Article` があれば更新、なければ新規作成する処理へ変更

- カテゴリの反映は `article.categories.set(...)` を用いて置き換える形へ変更


**設計方針:** 既存実装は常に新規`Article`インスタンスを生成して`save()`する作りで、`path`の一意制約もない。これまでは`ArticleImageFilter`が「DB上のpath・update_dateが一致する記事」を処理対象から除外していたため重複行が顕在化していなかった。今回、後述の`--force`オプションで既存記事を再処理してcontentをバックフィルする際、このままでは同じpathの記事が重複して作成されてしまう。そのため、path基準の更新(なければ新規作成)へ変更し、強制再実行時にも安全に既存レコードを更新できるようにする。


### 3. 本文取得フローの調整と--forceオプション追加(background/article_writer.py・background/article_image_loader.py・management/commands/generate_articles.py)


- `ArticleWriter.write` がGitHubから取得した生Markdown文字列を呼び出し元へ返却するよう変更

- `generate_articles` コマンドで、`ArticleWriter.write` から受け取ったMarkdown文字列を `ArticleModelWriter.write` の引数として渡すよう変更

- `ArticleImageLoader.load` に `force: bool = False` 引数を追加し、`force=True` の場合は `ArticleImageFilter` による絞り込み(変更なし記事のスキップ)を行わず全件を返すよう変更

- `generate_articles` コマンドに `--force` オプション(`store_true`)を追加し、指定時は `ArticleImageLoader.load(force=True)` を呼び出す


**設計方針:** 本文取得はGitHub APIを呼び出すため、同一記事に対して`ArticleWriter`・`ArticleModelWriter`それぞれが個別に取得すると呼び出し回数が倍になる。取得結果を使い回す形にすることで、無駄なAPI呼び出しを避ける。`--force`は、既存43件の記事についてcontentフィールドをバックフィルするために一度実行する想定だが、恒久的なオプションとして用意し、将来的にソース側の本文だけが変わり`update_date`が更新されなかった場合の再同期にも利用できるようにする。


### 4. 記事検索エンドポイント追加(views.py・urls.py・search_context.py)


- `blog/article/search_context.py` を追加し、`list_context.py` と同様に `ViewArticle`・`TypeContext`・`ContextGenerator` を定義する

- 検索語が空でない場合、`Article.objects.filter(Q(title__icontains=query) | Q(content__icontains=query))` により対象記事を絞り込む

- 検索語が空文字の場合は絞り込みを行わず全記事を返す

- 一覧画面と同様、`create_date` 降順で並び替え、`categories` を `prefetch_related` する

- `views.py` に `article_search(request)` を追加し、`request.GET.get('q', '')` を取得したうえで `search_context.generate_context` を呼び出し、`search.html` を描画する

- `urls.py` に `path('search/', article_search, name='search')` を追加する


### 5. 検索結果画面テンプレート追加(templates/search.html)


- `list.html` と同じカード形式(タイトル・カテゴリ・投稿日/更新日・要約)で検索結果の記事一覧を表示するテンプレートを追加

- 該当記事が0件の場合は、`list.html`のカテゴリ絞り込み時と同様、メッセージなしで空表示とする


### 6. ヘッダーへの検索ボックス追加(templates/base.html)


- ヘッダー内に検索フォーム(GETメソッド、`action="{% url 'blog:search' %}"`、`input[name="q"]`)を追加する

- 入力欄には既存の検索語を反映しない(常に空欄で表示する)


---


## テスト観点


### `tests/blog/article/views_test.py`


**ファイル:** `tests/blog/article/views_test.py`


`TestArticleList` と同様の構成で `TestArticleSearch` クラスを追加する。


| テストメソッド | 条件 | 期待 |

|---|---|---|

| `test_context` | `q`パラメータ付きでリクエスト | レスポンスの`context['articles']`が存在する |

| `test_template_path` | `blog:search`へリクエスト | `search.html`が使用される |

| `test_search_by_keyword` | タイトル・本文それぞれに一致する記事が存在する状態で`q`を指定してリクエスト | 一致する記事のみがコンテキストに含まれる |


テストデータは `tests/blog/article/db_factory/article.py` 配下の関数(`insert_articles()`)で生成し、テスト末尾で `db_teardown()` を呼んで後始末する。


### `tests/blog/command/generate_articles_test.py`


**ファイル:** `tests/blog/command/generate_articles_test.py`


`--force`オプションを指定したコマンド実行に関するテストを追加する。


| テストメソッド | 条件 | 期待 |

|---|---|---|

| `test_generate_articles_force` | 変更なしと判定される既存記事が存在する状態で`call_command('generate_articles', '--force')`を実行 | 当該記事についても本文取得・ファイル書き出し・DB更新(`content`含む)が行われる |


テストデータは `tests/blog/command/generate_articles_test.py` 内のモック(`get_mock_response`)および `use_test_template_directory`・`use_test_article_image_directory` フィクスチャを用いる。
実装する機能にもよりますが、設計書は大きくても200行以内に収まるよう心がけています。
大きすぎると人間が理解しようと思ったときに疲れますし、実装もブレるように感じます。
なので、チケットのタスクを一気に実現するのではなく、設計書が大きくなりそうならタスク分割をするよう心がけました。
実際にこのようなやり方で運用してみると、読み書きするときの負荷もちょうど良いぐらいに落ち着いたので、いい感じに運用できている気がします。
実装
設計書が出来上がったら、ClaudeCodeにタスクリストの順序に従って実装してもらいます。
このとき、機能が完成するまで待つのではなく、タスクごとにPRレビューをするように差分を逐一確認していきます。
…
記事の続きは下のURLをクリック!
https://rightcode.co.jp/blogs/56610
もっと上を目指したあなたへ
現在、ライトコードでは「WEBエンジニア」「データエンジニア」「ゲーム・XRエンジニア」「UI/UXデザイナー」「PM/PMO」などのポジションで積極採用中です!
ライトコードは、技術力に定評のある受託開発をメインにしているIT企業。
有名WEBサービスやアプリの受託開発などの企画、開発案件が目白押しの状況です!
- もっと大きなことに挑戦したい!
- エンジニアとしてもっと成長したい!
- モダンな技術に触れたい!
現状に満足していない方は、まずは一度、【Wantedly内の弊社ページ】をのぞいてみてください。