株式会社STAR AIの技術チームです。
弊社ではテックブログを更新しているのですが、そこで公開された技術情報を
wantedly内でも共有します。
今後もテックブログシリーズや技術の最新情報などがあれば発信していきます。
どうぞよろしくお願いいたします。
少し長くなりますが、ぜひお時間のある方は最後まで見ていただけると嬉しいです。
目次
はじめに
今回は、LLM(大規模言語モデル)を活用した機能開発にあたり、GPUサーバーを構築する必要があったため、その手順を備忘録としてまとめました。
AWSのGPUインスタンスを使い、LLMが動作可能な開発環境をゼロから構築する流れをご紹介します。モデルのサイズや使用用途によって求められるGPU性能は異なりますが、本記事の手順で多くのケースに対応できるはずです。
必要な環境(構築時に選定が必要な項目)
ここでは、LLMを動作させるために必要な環境のうち、特にプロジェクトや利用者ごとに構成が変わるポイントを中心に整理しています。ネットワーク接続やエディタの準備といった基本的な部分は割愛し、それぞれの環境に応じて補っていただければと思います。
1. AWS関連(構築時に選ぶことになる項目)
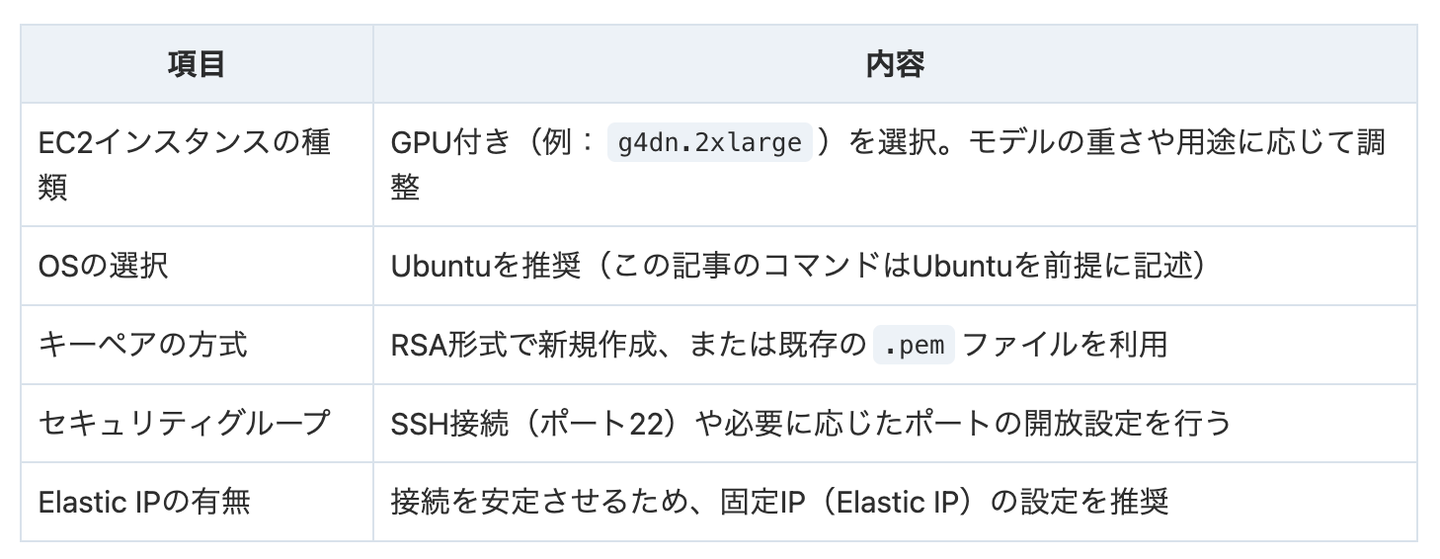
2. サーバー内環境(プロジェクトに応じて変わる構成)
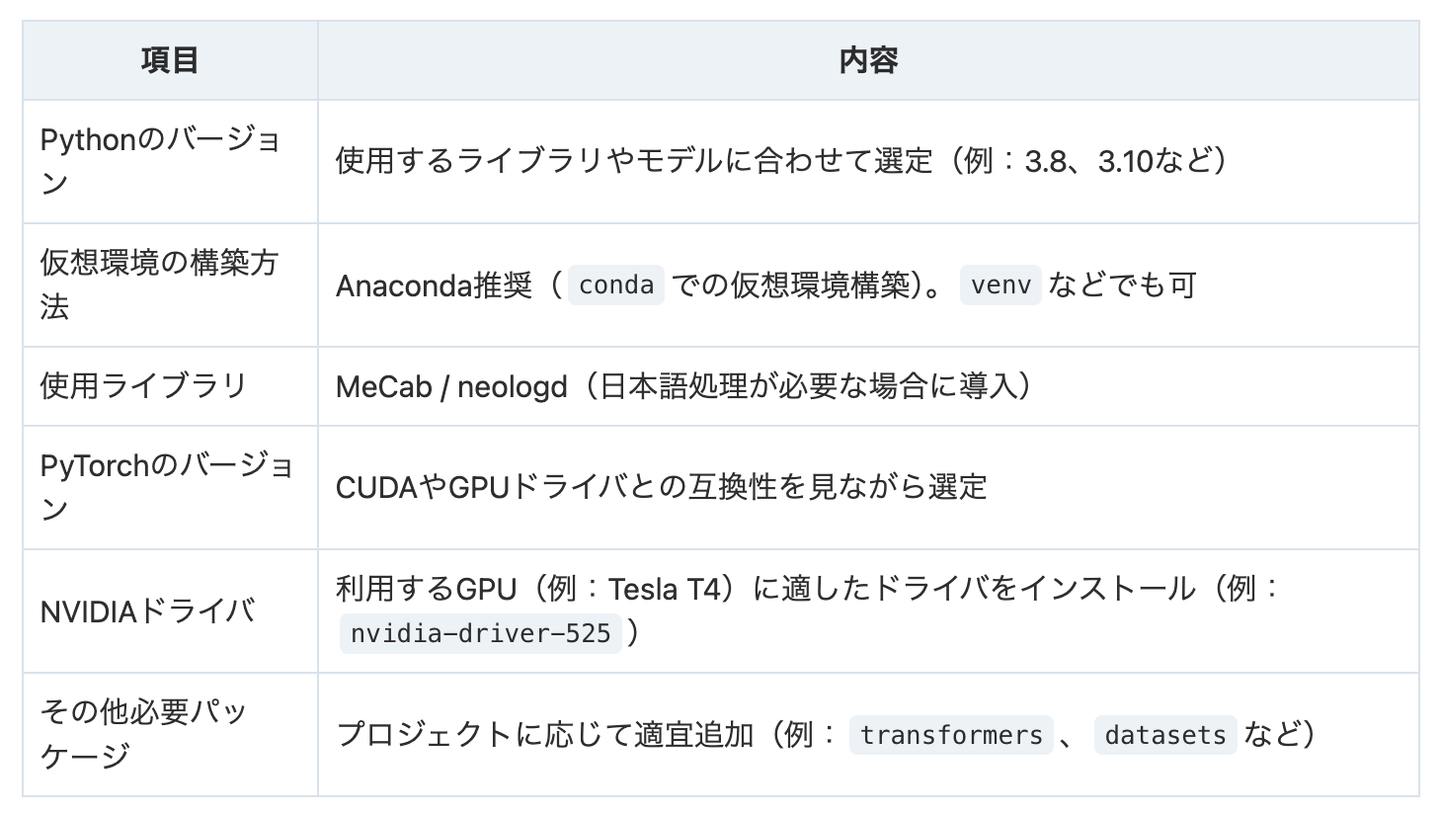
AWSインスタンスの作成
AWSでGPUインスタンスを作成する手順を解説します。インスタンスのタイプやOS、キーペアの設定など、実際に使い始めるまでの基本構成を整えていきます。
1. EC2サーバーにログイン
AWSマネジメントコンソールにログインし、「EC2」サービスを開きます。インスタンスの管理画面から「インスタンスを起動」をクリックします。
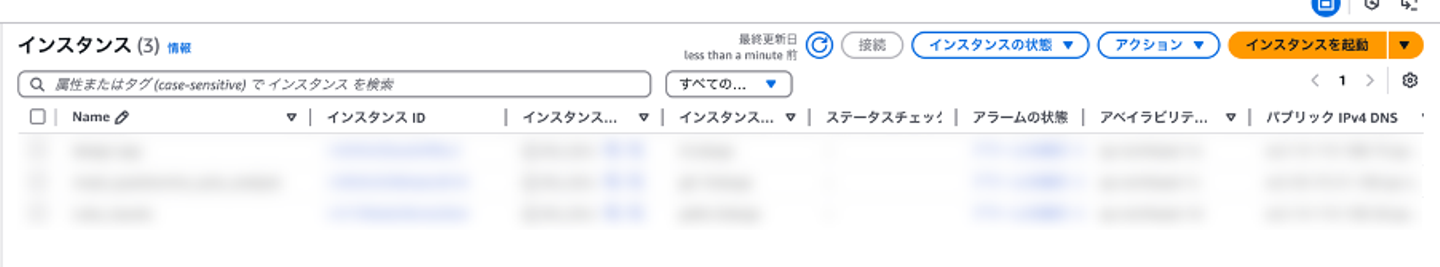
2. インスタンス名を入力
インスタンスに任意の名前を設定します。チームで共有する場合は、タスク名や目的がわかりやすい名前にしておくと管理がスムーズです。
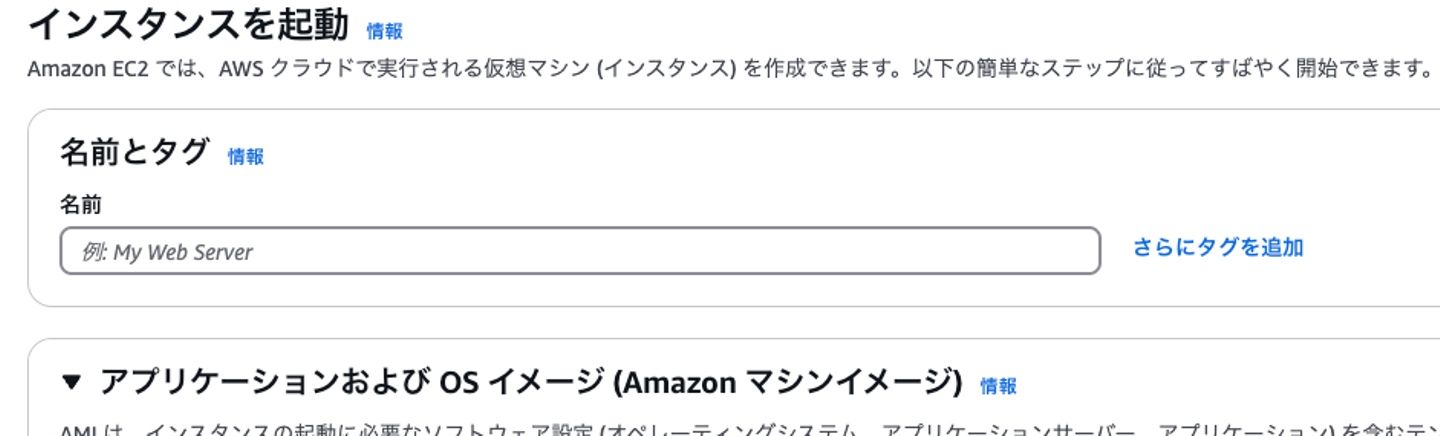
3. OSを選ぶ
使用するOSは「Ubuntu」を選びます。本記事の手順はUbuntu環境に基づいています。他のOSを使用する場合は、コマンドの違いに注意してください。
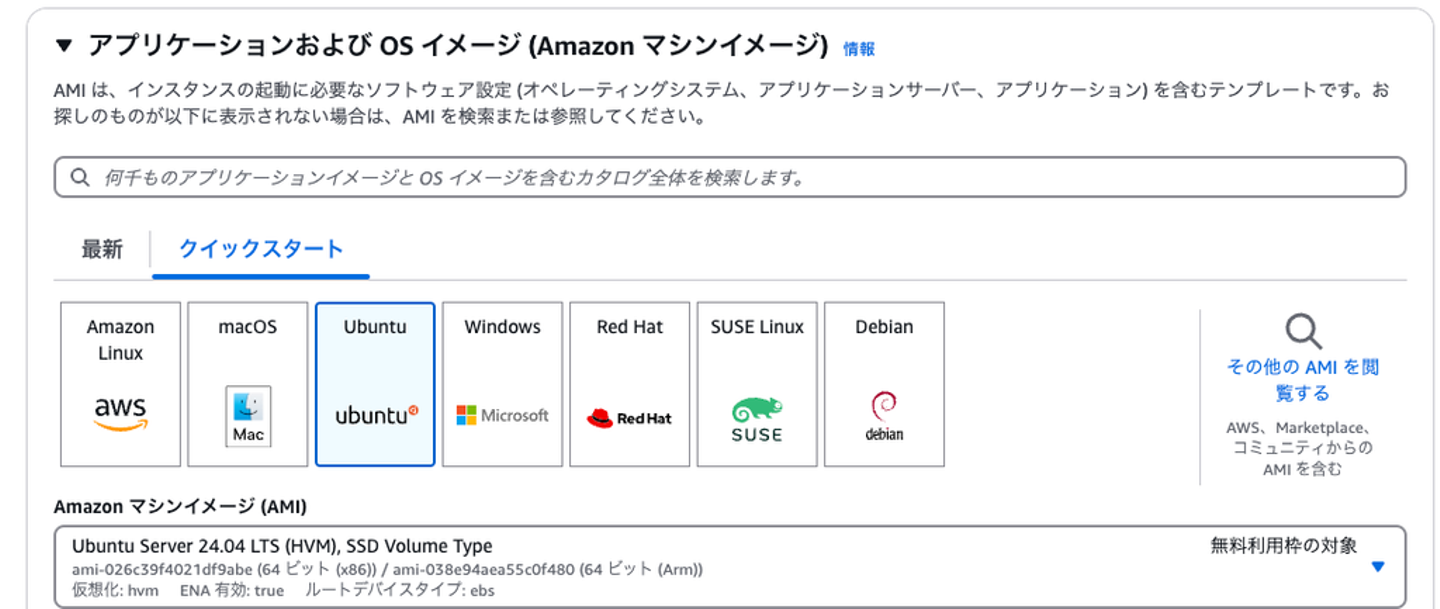
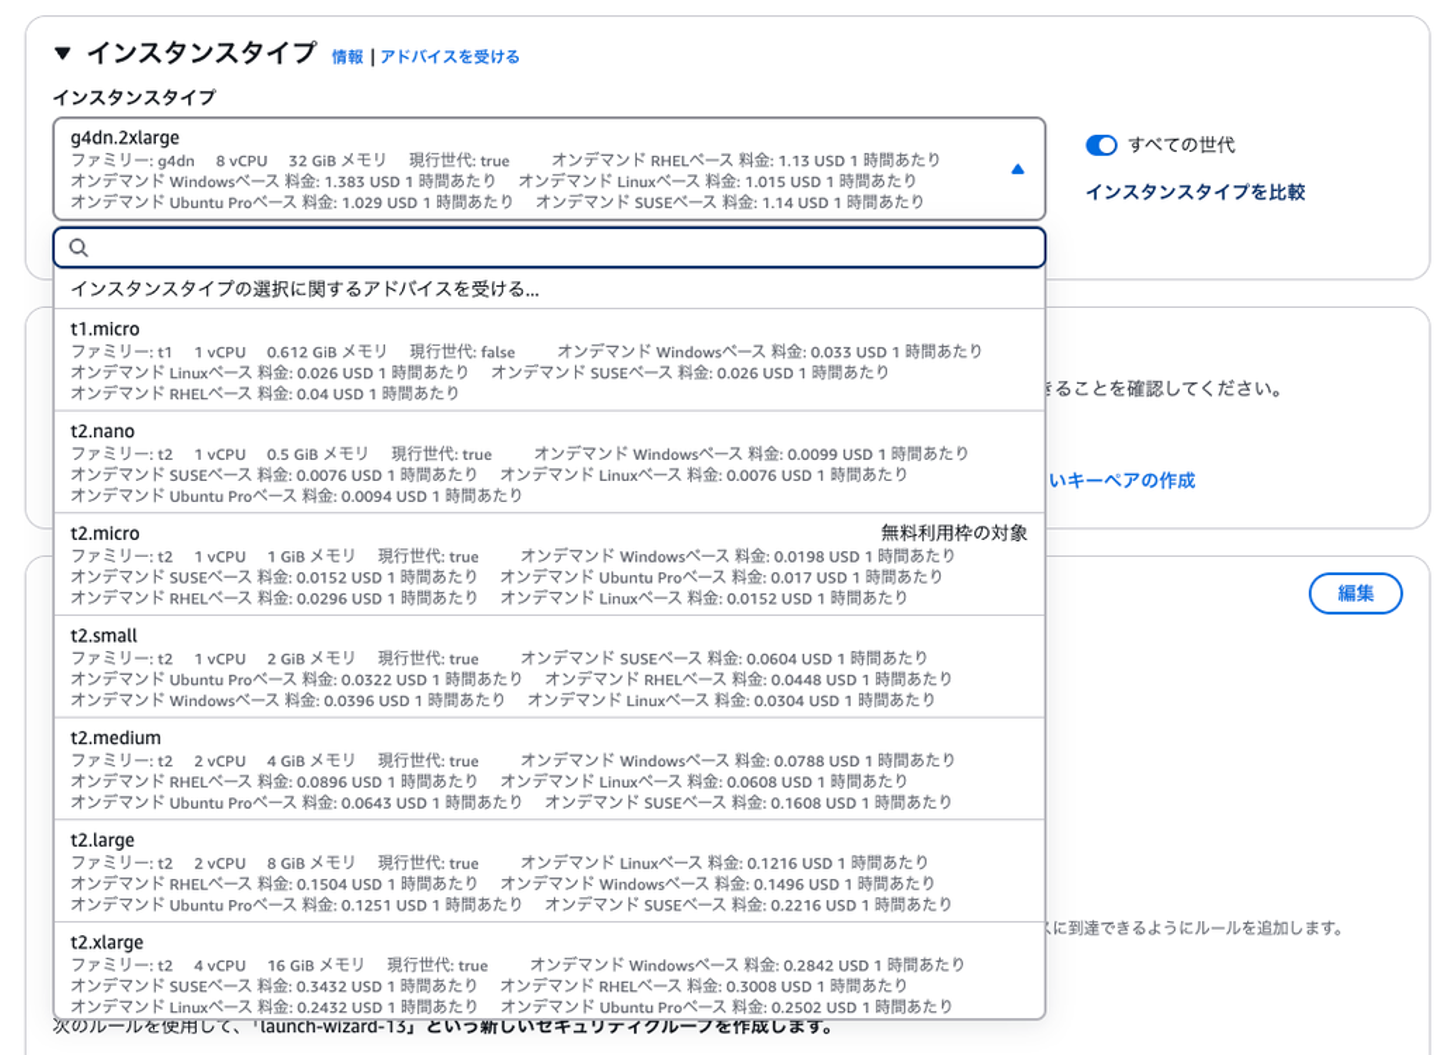
4. インスタンスタイプを選ぶ
LLMの処理にはGPUが必要なため、GPU搭載のインスタンスタイプを選択します。今回は「g4dn.2xlarge」を例にしていますが、モデルのサイズや用途に応じて適宜選択してください。
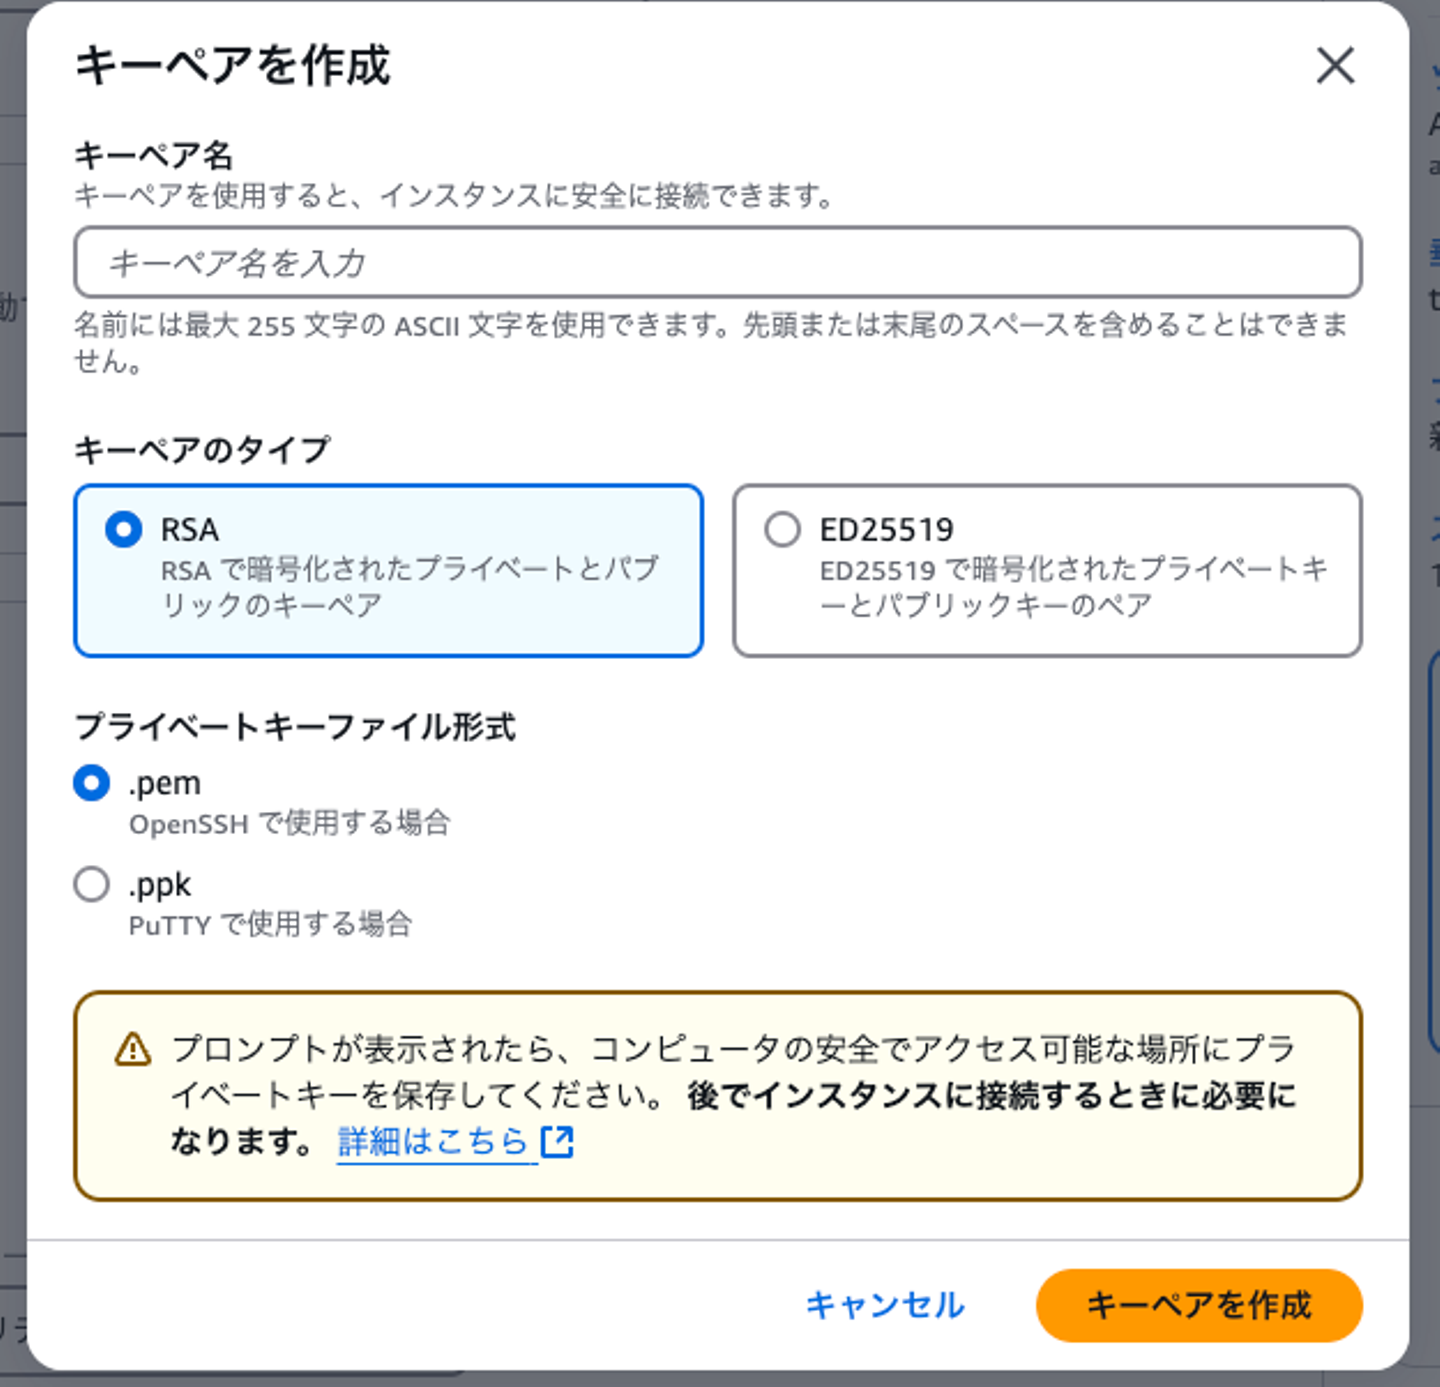
5. キーペアの作成
SSH接続用のキーペアを作成します。すでにキーペアがある場合はそれを再利用しても問題ありません。新しく作成する場合は以下を参考にしてください。
- キーペア名:お好きな名前で良いです
- キーペアタイプ:「RSA」
- ファイル形式:「.pem」を選択してください
作成した秘密鍵(.pemファイル)は、安全な場所に保管しましょう。
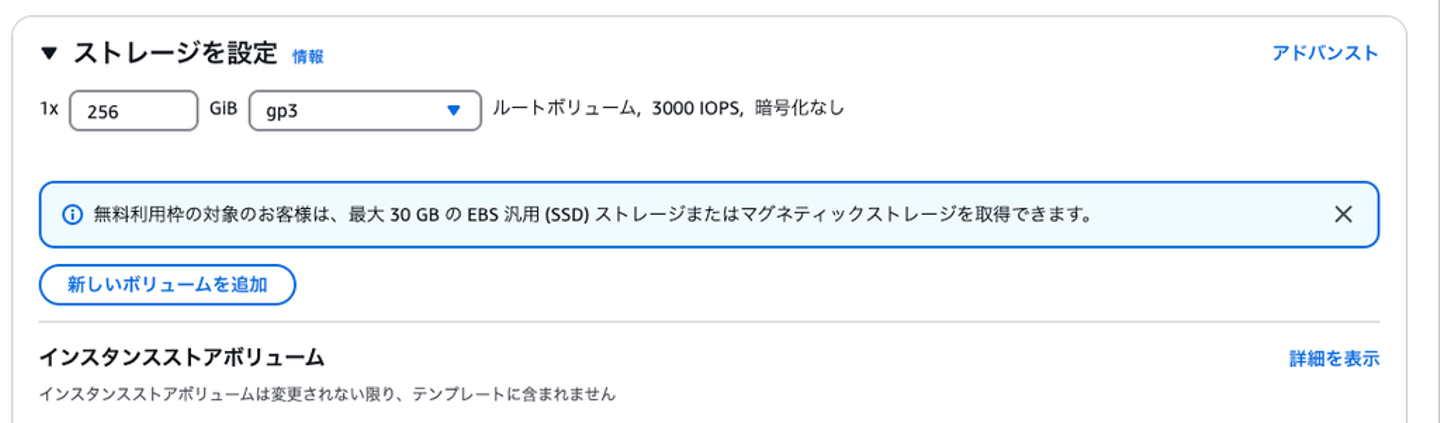
6. ストレージを入力
必要に応じてストレージサイズを指定します。今回は256GiBを設定していますが、用途に応じて変更可能です。ルートボリュームはデフォルト設定のままで問題ありません。
Elastic IPの設定
EC2インスタンスを作成した直後は、接続のたびにパブリックIPアドレスが変更される仕様になっています。これではSSH接続のたびにIPアドレスを確認する手間がかかるため、**Elastic IP(固定IP)**を割り当てて接続を安定させましょう。
1. Elastic IPの管理画面に移動
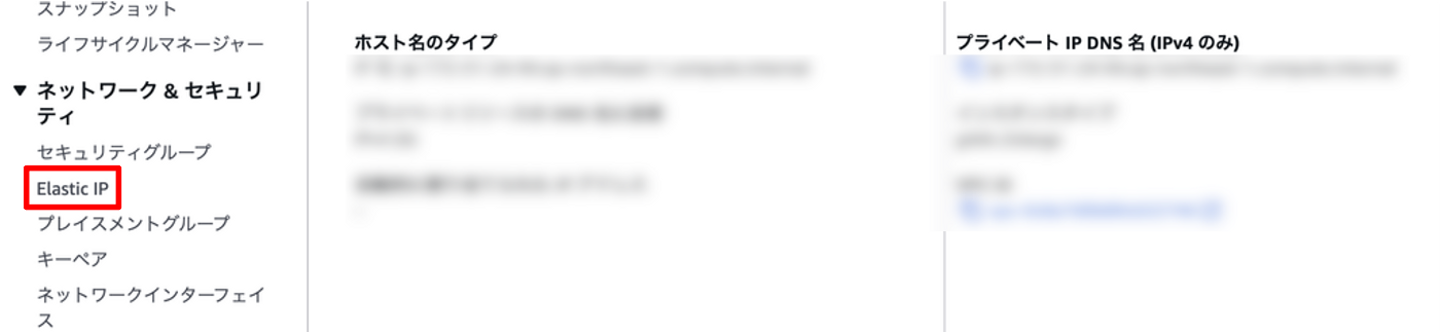
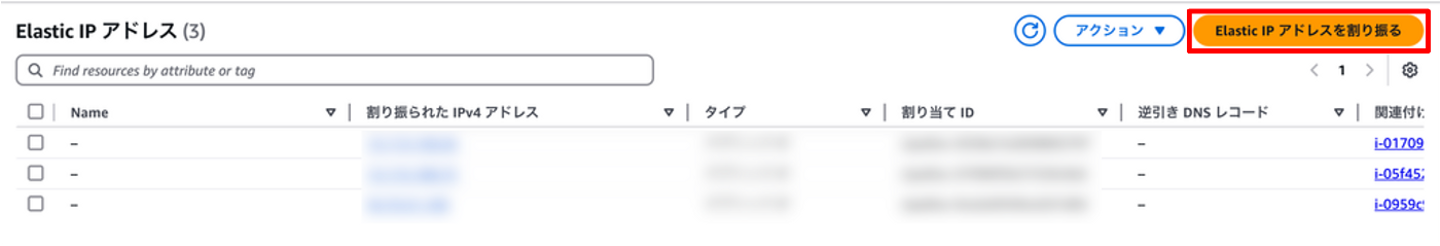
EC2ダッシュボードの左側メニューから「ネットワーク&セキュリティ」内の「Elastic IP」をクリックし、「Elastic IP の割り当て」ボタンを選択します。設定は基本的にデフォルトのままで問題ありません。「割り当て」ボタンをクリックすれば、Elastic IPが発行されます。
2. IPアドレスを紐づける
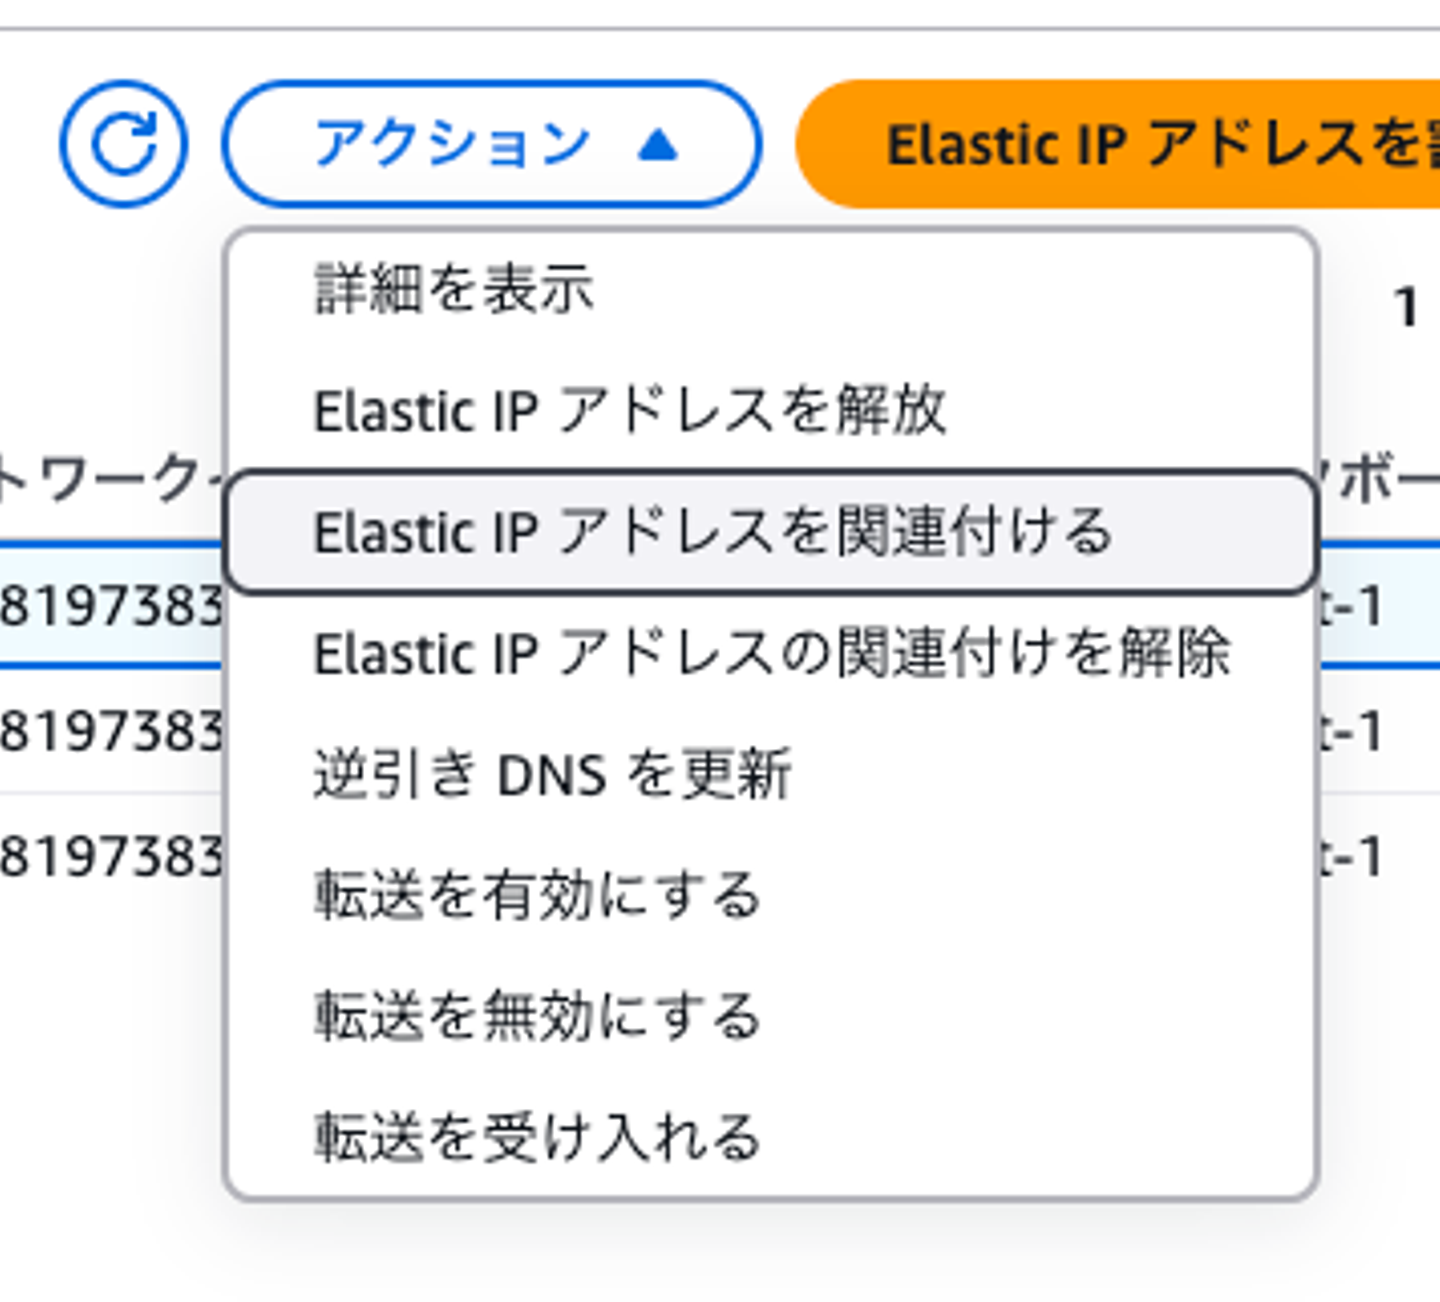
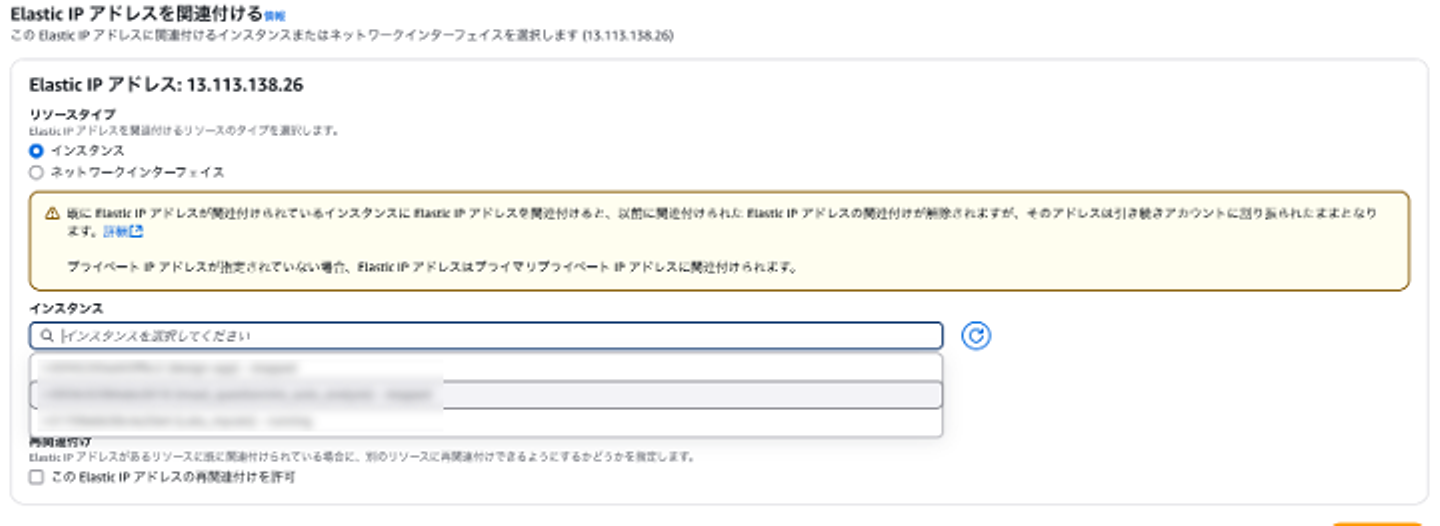
取得したElastic IPを選択し、「アクション」メニューから「Elastic IP アドレスの関連付け」を選択します。表示される画面で、先ほど作成したEC2インスタンスを指定し、「関連付け」を実行してください。これで、EC2インスタンスには固定のパブリックIPアドレスが設定され、今後は常に同じIPでアクセスできるようになります。
キーファイルの保存先と権限設定
1. キーファイルの保存先を確認
Macの場合、ファインダーでキーファイル(.pem)を右クリックし、「情報を見る」からパスを確認するか、optionキーを押しながらファイルを右クリックして「パス名をコピー」することで取得できます。
2. 権限の変更コマンドを実行
ターミナルを開き、以下のコマンドでキーファイルの権限を変更します。

3. 権限が正しく変更されたか確認
以下のコマンドを入力することで、キーファイルの権限が確認できます。読み取り権限(r)が付与されていることを確認してください。

表示された結果に -r-------- のような権限が表示されていれば設定完了です。
SSH接続の設定
キーの権限を設定したら、SSH接続の準備を進めましょう。ここでは、VSCodeの「Remote - SSH」拡張を使ってEC2インスタンスへ接続する方法を紹介します。
1. SSH設定ファイルの編集
SSH設定ファイル(~/.ssh/config)を開いた後に、次のような内容を追記してください。
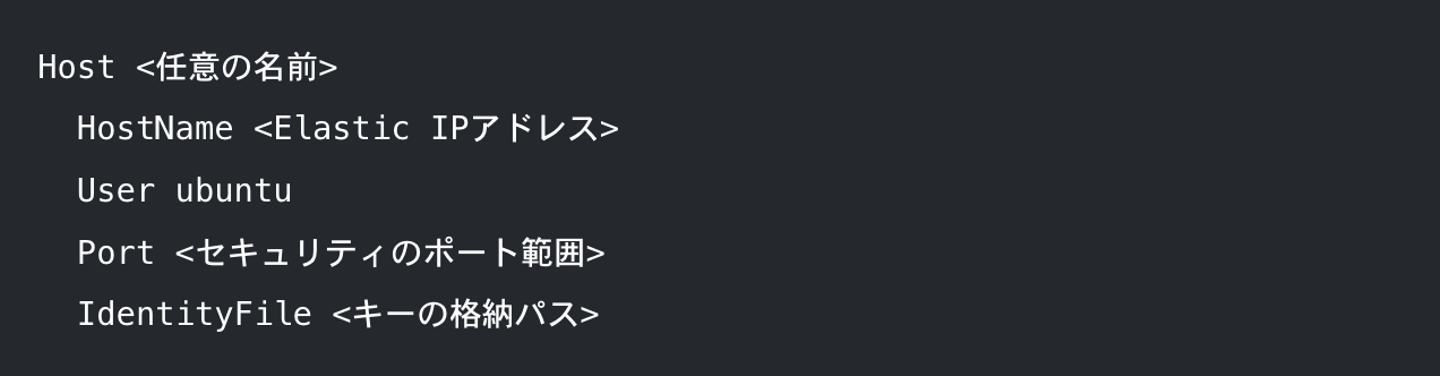
- HostName には、Elastic IPアドレスを入力します。
- IdentityFile には、先ほど権限を設定した
.pemファイルのパスを指定します。
2. VSCodeでリモート接続
VSCodeを起動し、「Remote - SSH」拡張機能を使用して、先ほど設定したホスト名(例:aws-llm-server)を選択します。正常に接続できれば、インスタンス上のターミナルが開き、リモートで作業ができるようになります。
Anacondaのインストール(仮想環境構築)
ここでは、LLMの開発環境を整えるために、Anacondaを使用して仮想環境を構築する手順を解説します。
1. ディレクトリの作成
作業ディレクトリを以下のコマンドで作成します。

2. Anacondaのダウンロード
Anacondaの公式サイト(Download Anaconda Distribution | Anaconda)から、Linux版のインストーラーリンクを取得し、以下のようにインストールします。

インストール途中で表示される質問には基本的にyesで進めて問題ありません。
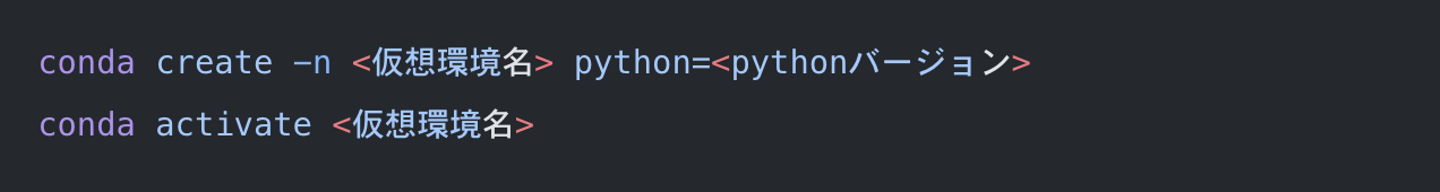
3. 仮想環境の作成と有効化
以下のコマンドで仮想環境を作成し、アクティベートします。
nvidia-smiのインストール
GPUを活用するには、対応するNVIDIAドライバのインストールが必要です。以下の手順でドライバの導入とGPUの動作確認を行います。
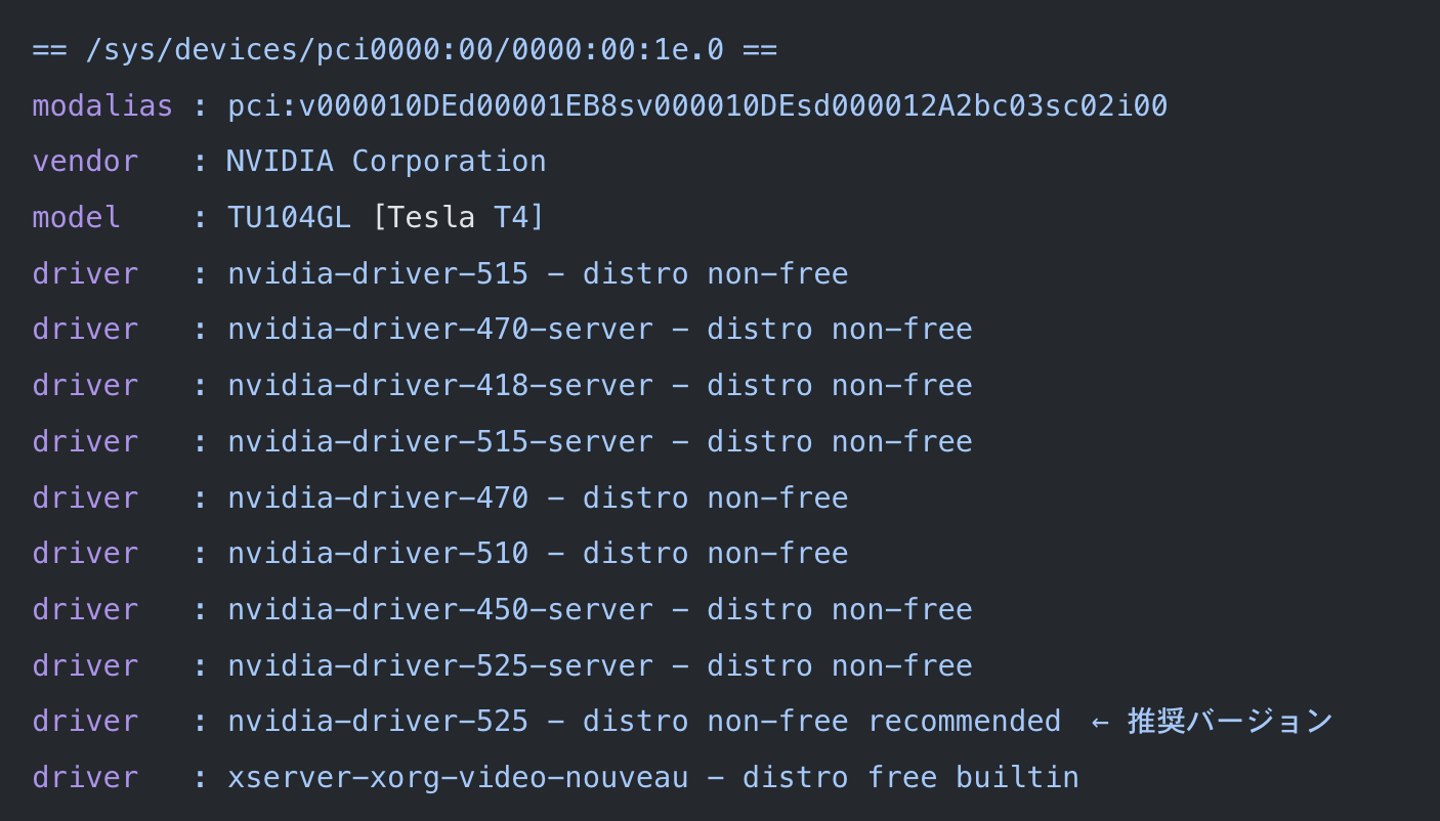
1. 推奨ドライバの確認
推奨されるNVIDIAドライバを確認します。
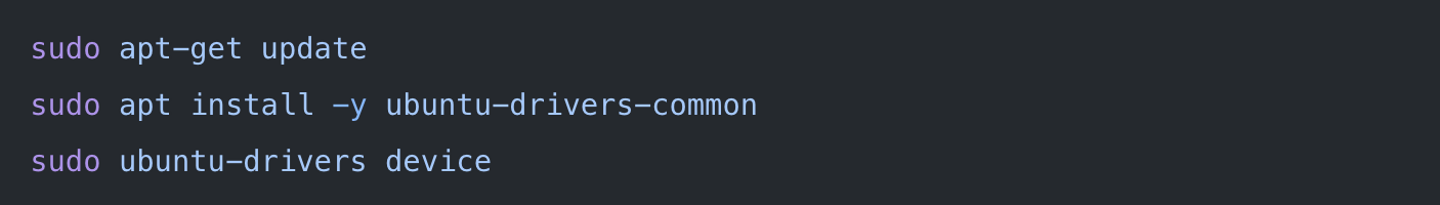
以下のような結果が示されるので”recommended”のドライバをインストールするのが良い。
2. ドライバのインストール
表示された推奨バージョン(例:nvidia-driver-525)を以下のようにインストールします。

3. インスタンスの再起動
インストール後、インスタンスを再起動してドライバを有効化します。

4. 動作確認(nvidia-smi)
再起動後、以下のコマンドでGPUが正しく認識されているかを確認します。

GPUの情報(モデル名、使用率、メモリ使用量など)が表示されれば、ドライバのインストールとGPUの認識に成功しています。
必要ライブラリのインストール
MeCabとPytorchのインストールは注意が必要
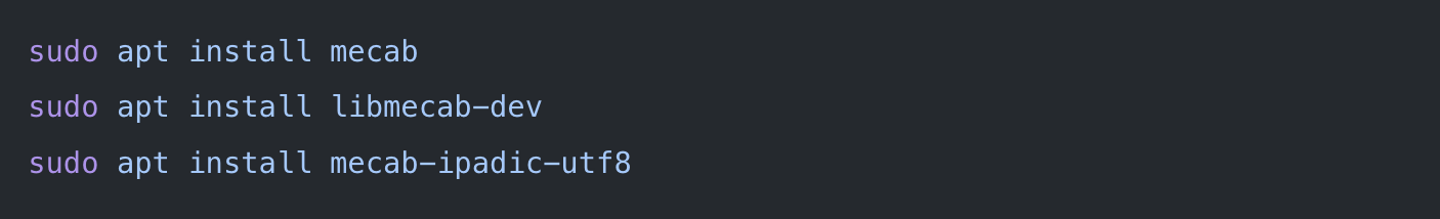
1. MeCabのインストール
MeCabを以下コマンドでインストール。入力を求められた場合には全て”y”(Yes)で良い
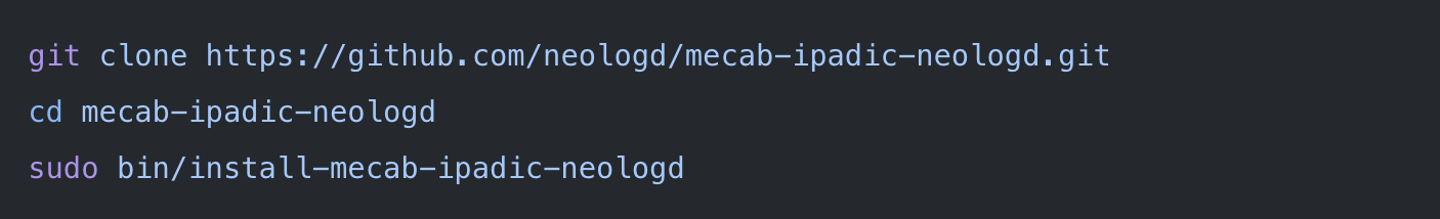
2. mecab-ipadic-neologdのインストール
mecab-ipadic-neologdをインストールする。以下コマンドを使用する
3. Pytorchのインストール
PyTorch から”Your OS”, “Language“, “Compute Platform“を選択してコマンドを取得する
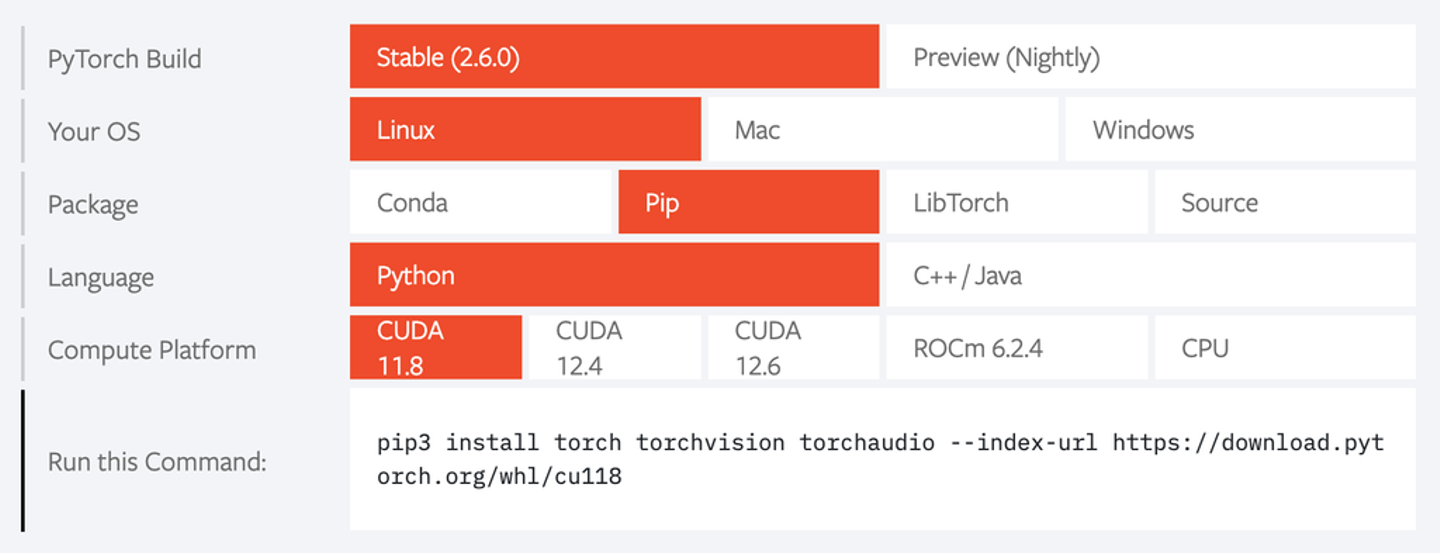
ターミナルに取得したコマンドを入力し”Pytorch”をインストールする
4. その他のインストール
他に必要なものがあればインストールする

モデルを稼働させる
最後にテストとしてELYZAのLlama3 8Bを読み込んで動かします。
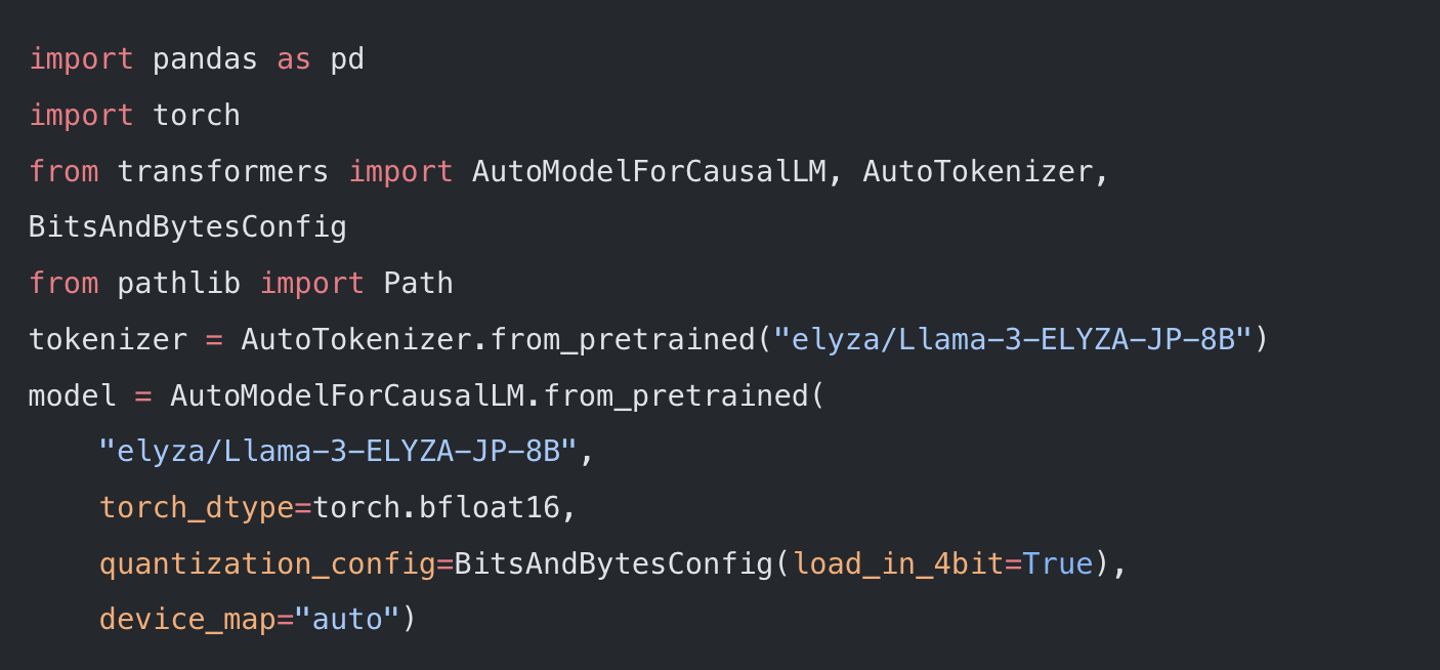
1. モデルの読み込み
最初にモデルを稼働させるためのtokenizerとmodelを読み込みます。
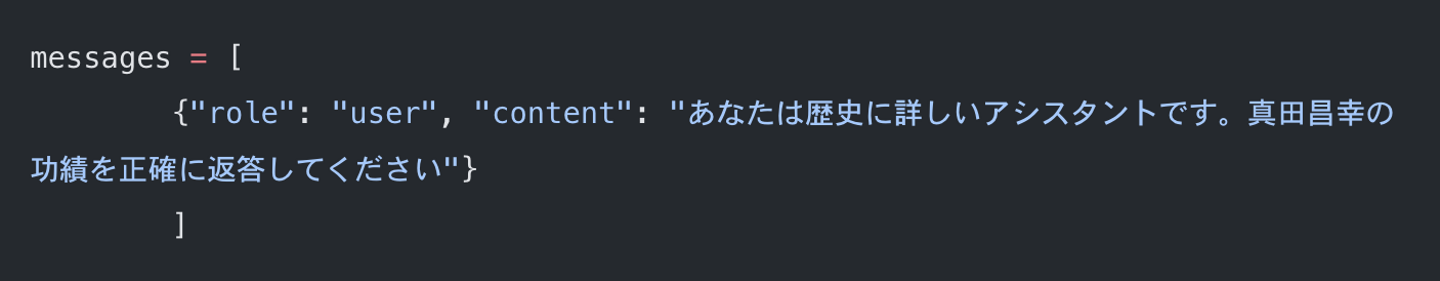
2. プロンプト
LLMに聞く内容を入力します。今回は個人的な推し武将、”真田昌幸”の功績を聞いてみます。
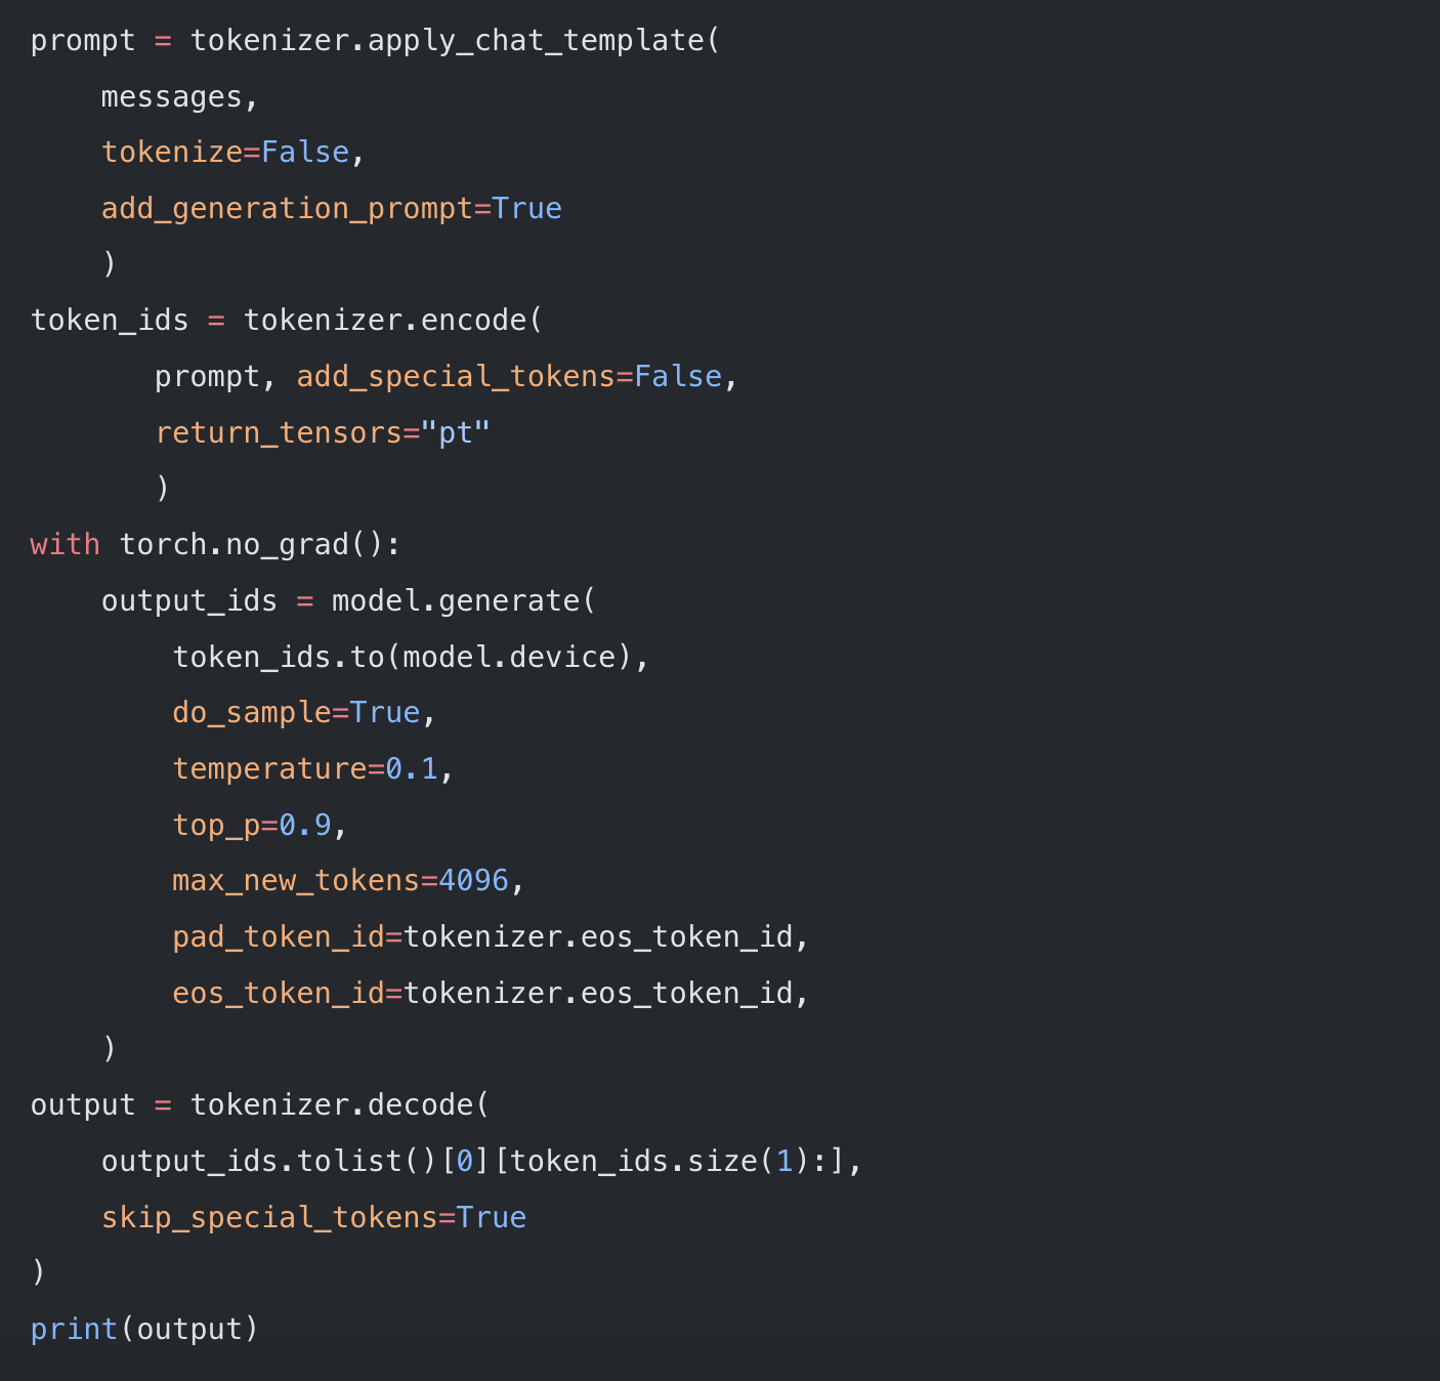
3. 出力の制御
メッセージをモデルが理解しやすい形に整え、それをトークンという数値の形式に変換します。その後、モデルに続きを生成させるのですが、その際に「出力の長さ」や「どれくらい創造的にするか」などの細かい設定を行うことで、出力の内容をコントロールしています。
4. 結果
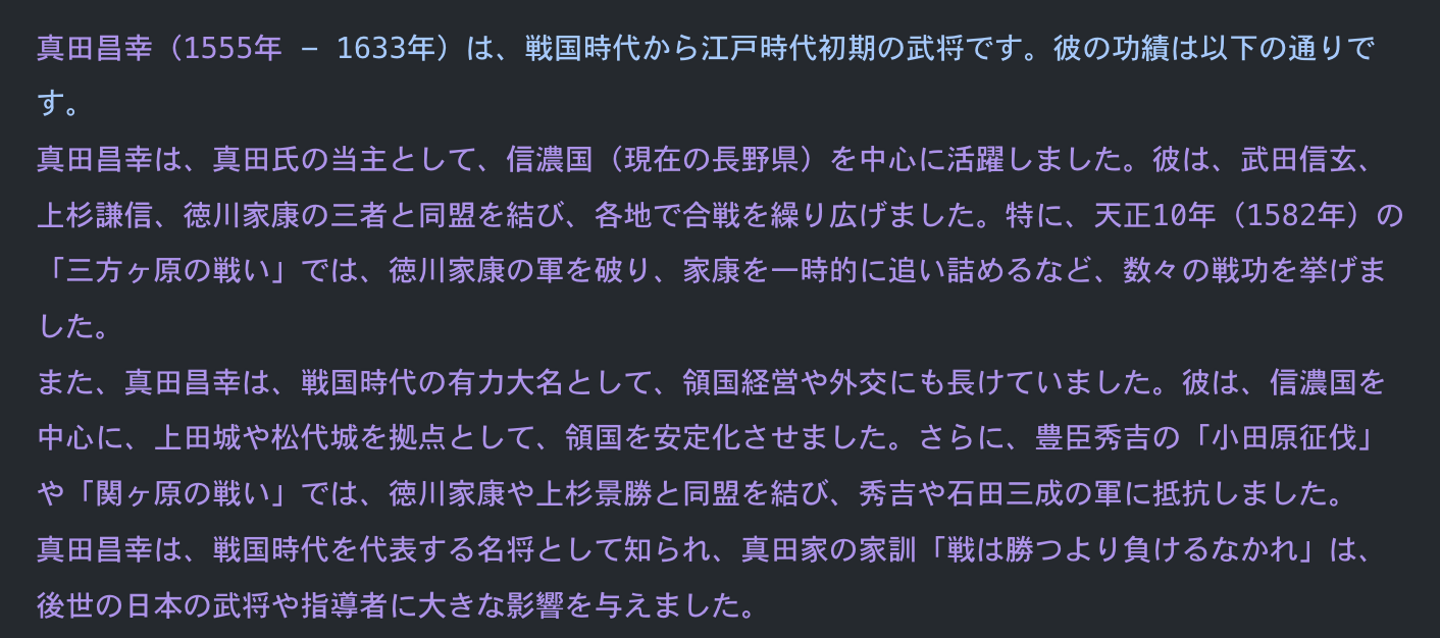
はい、半分くらい嘘ですね。モデルの精度が良ければ正しい返答をしてくれると思いますがLlama3の8Bでは調べものは不向きです。
おわり
以上、LLMを使用するためのGPUサーバー構築手順をご紹介しました。NVIDIAのGPUを搭載したEC2インスタンスを活用することで、LLMの開発・実行環境を効率的に整えることができます。本記事の内容が、同様の環境構築に取り組まれる方の一助となれば幸いです。


/assets/images/21114699/original/ecbd5c65-0a89-4592-8424-105d8b27d11a?1747240698)